AI×経営戦略
冒頭の一語が基盤モデルの推論力を引き出す
基盤モデルの応答冒頭に特定の語を固定するだけで、強化学習済みモデルに迫る数学・コード性能が得られると判明した。再学習なしで性能を引き出す手法として、AI運用コストの見直しにつながる。
494 件
基盤モデルの応答冒頭に特定の語を固定するだけで、強化学習済みモデルに迫る数学・コード性能が得られると判明した。再学習なしで性能を引き出す手法として、AI運用コストの見直しにつながる。
台湾の研究チームが、フローチャート画像を任意の縦横比へ接続を壊さず再配置し、編集可能な形式で出力するAIパイプラインを発表した。資料作成の転用工数を減らす技術として注目される。
研究チームが、40億パラメータで一般的なグランドマスター級に指し、手と計画を自然言語で説明するチェスLM「Queen」を発表した。専門エンジンと言語モデルを融合する手法で、業務AIの説明可能性向上に道を開く。
DINOv2の内部トークンを分析した研究で、レジスタ由来の特徴を壊すと表現が48.17%変化し、外れ値由来では0.31%にとどまった。画像AIの解釈性と軽量化に資する知見である。
大規模言語モデルの追加学習用データを選ぶ際、出力層の勾配だけで全勾配に近い性能を保てることが判明した。特徴抽出の演算量はSFTで9.7分の1に減り、AI開発費の抑制に直結し得る。
中央サーバーなしで各拠点が協調し最適解を求める分散最適化で、通信網の構造から計算の分担まで一体設計する新手法GATEが提案された。線形収束も理論的に保証され、設計指針となる。
環境変化に適応する世界モデルでは、古い知識の破棄は欠陥ではなく必須動作だとする論文が公表された。物理法則など不変知識と更新すべき事実を分けて評価する枠組みを示し、AIの品質保証の見直しを迫る。
複数のRL教師の能力を1つの小型モデルへ統合する蒸留で、損失の平均化方式や数値精度が成果を左右することが判明した。AI開発の品質管理と計算コストに直結する知見である。
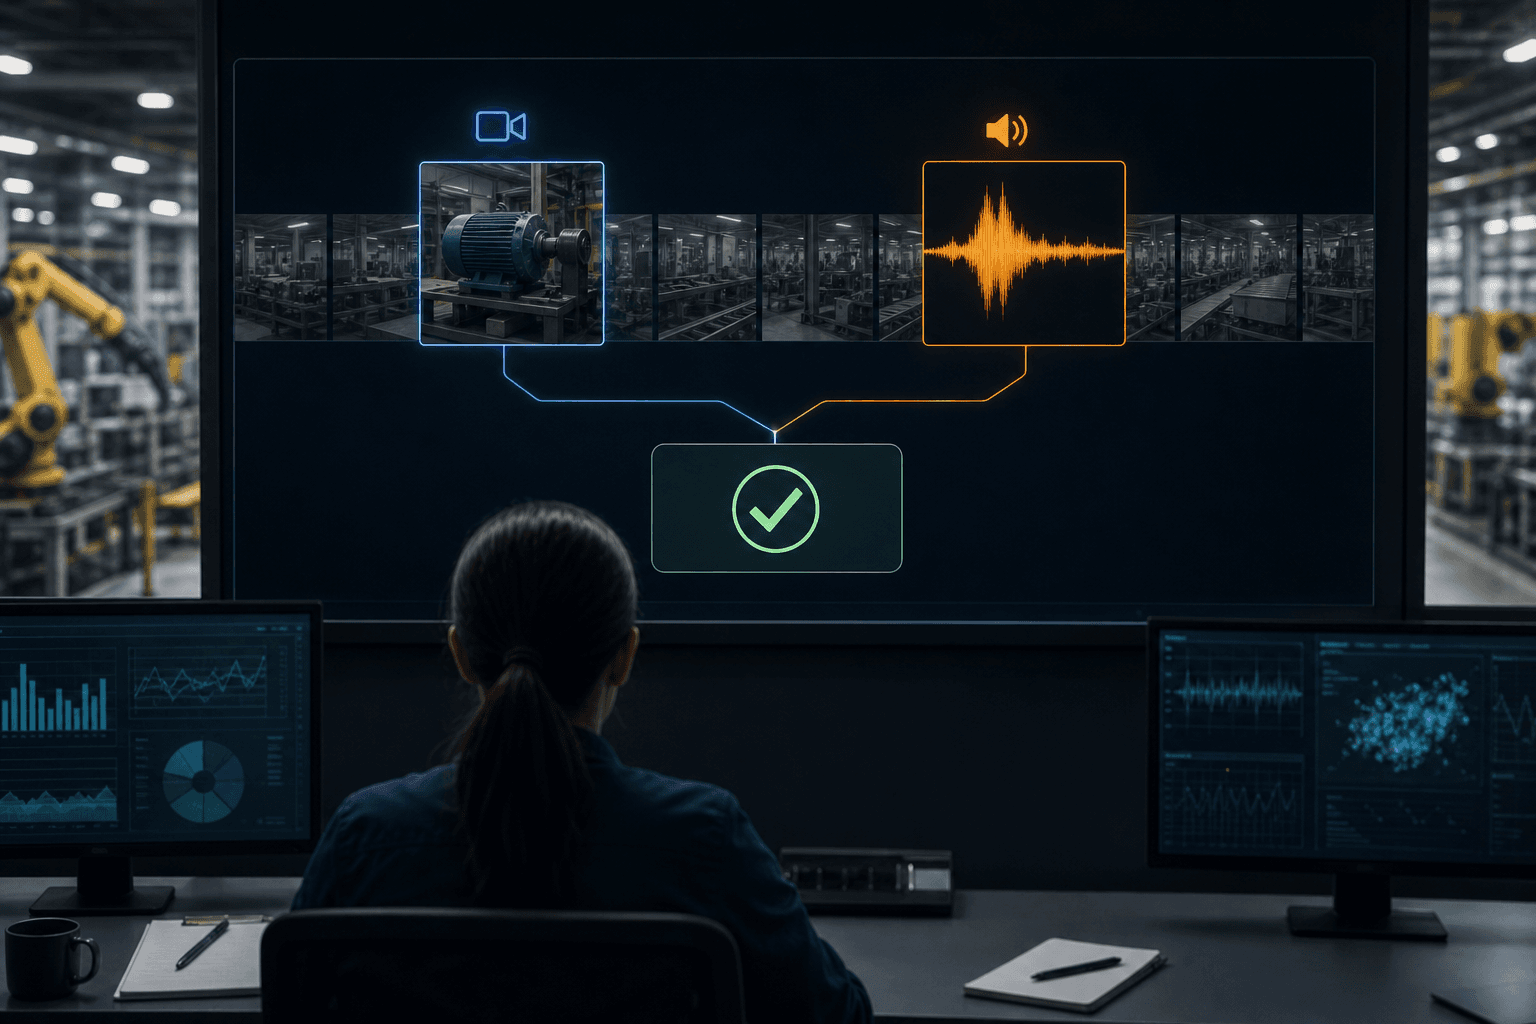
長い音声付き映像から、必要な場面を自ら選んで見聞きする推論AI「OmniSeek」が登場した。映像と音声の両方を根拠とする推論を促し、監視や会議分析の精度向上に道を開く。
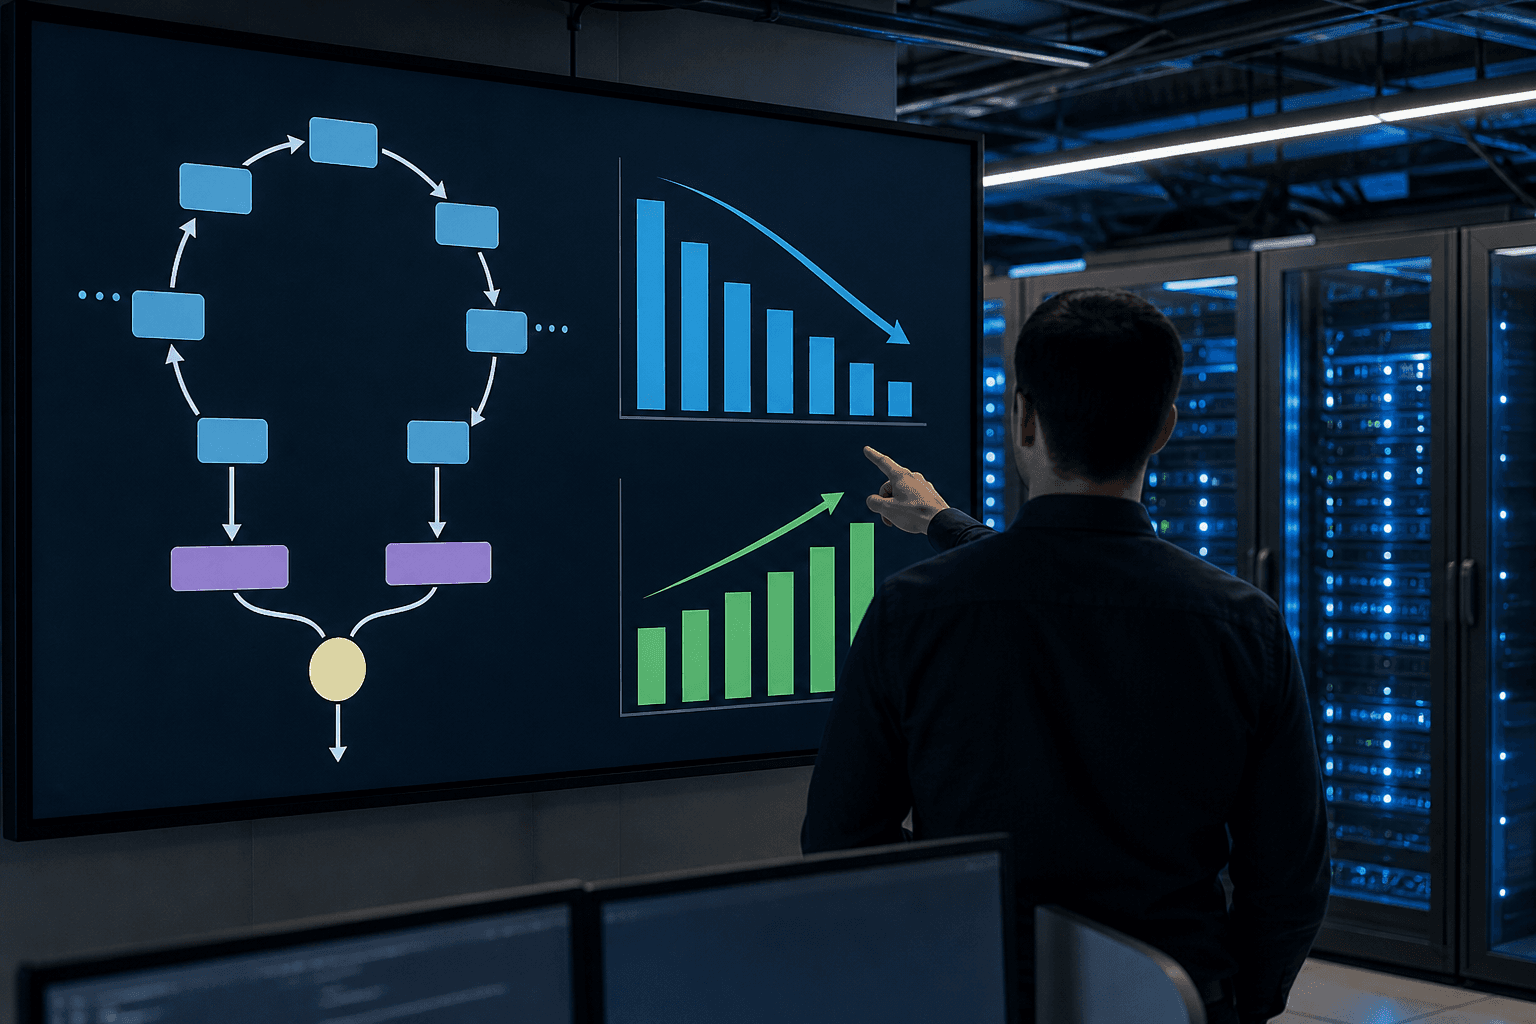
米研究チームが、ループ型Transformerの途中計算を活用し追加学習なしで推論精度を高める手法LoopCDを開発した。ループ数を半減しても同等以上の精度を保ち、演算量を最大48.2%削減した。
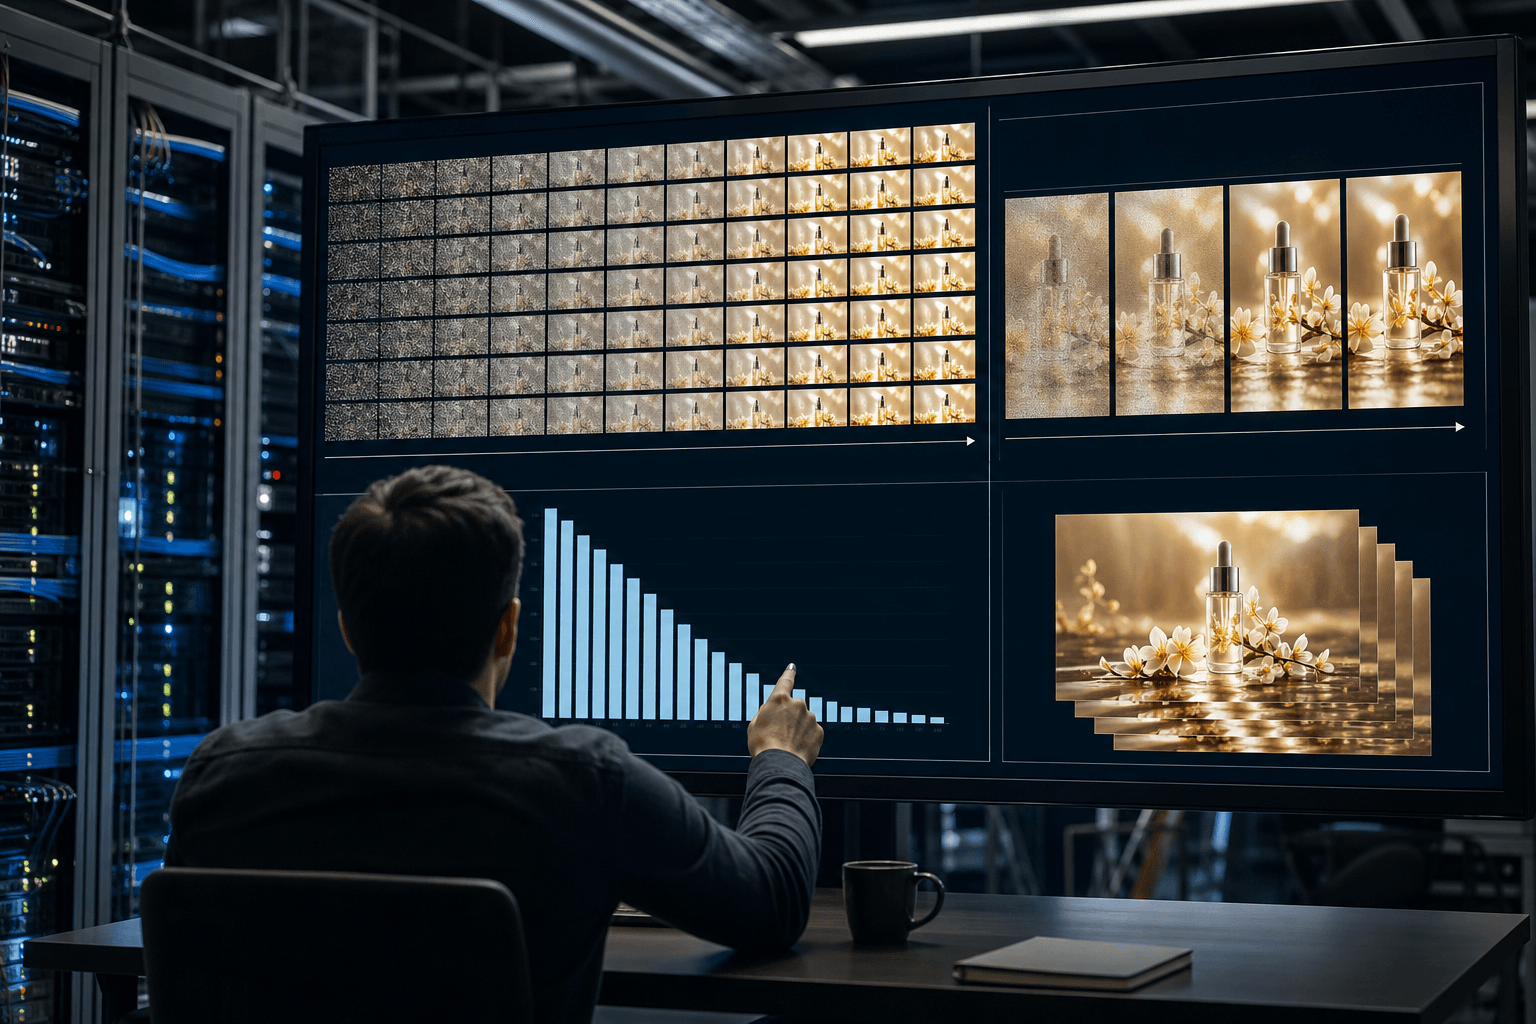
中国・米国の研究チームが、拡散モデルを少ステップで動かす蒸留手法DMADを発表した。補助モデルを不要とし、1~4ステップで教師モデルを上回る品質を示し、生成コストの削減に道を開く。
米大学などの研究チームが、LLMの数学的理解を4能力で診断する新指標を提案した。正答率に隠れた弱点は「発見」にあり、補強で推論精度が向上するため、業務AIの品質改善に直結する。
米クアルコム系研究者らが、複数の物理法則が同時に働く動画を生成する強化学習手法HiPhyを提案した。物理的な不自然さを抑え、映像の実用化に向けた課題解決につながる成果である。
研究チームが、LLMの全パラメータ微調整でオプティマイザ状態を174分の1に削減する手法TACOを発表した。80GBのGPU1枚で30B級モデルを扱え、調達費の抑制につながる可能性がある。
一次最適化で方向を決め、ステップ幅のみを2回の追加評価で探索する新手法ZFOが提案された。LLM微調整の安定性と最終性能を高め、計算コストを抑える可能性がある。
米国の研究チームは、離散トークン生成と連続潜在軌道を一体で扱う拡散言語モデルHC-DLMを提案した。数独などの推論課題で既存の拡散モデルを上回り、制約充足型の業務AIへの応用が期待される。
グラフ上で分布間の質量移動を費用付きで最適化する問題に、学習を要しない厳密解法が示された。路線網などの大規模ネットワークで、計算資源の削減と経路制御の精度向上が見込まれる。
MITなどの研究チームは、視覚記憶を備えた補助基盤「VISTA」を開発した。ARC-AGI-3で、Claude Opus 5.0の行動効率が40.68から100.00に向上した。
スタンフォード大などの研究チームは、研究着想の源となった先行論文をAIが探せるかを測るベンチマークを公開した。最高性能のエージェントでも再現率は0.51にとどまり、R&D現場での検索支援の限界が示された。
画像生成の拡散Transformerに、ステップごとに更新する予測埋め込みを条件として与える手法NEPAが提案された。ImageNetでFID1.32を達成し、学習計算量は従来REPAの約3分の1である。