AI×経営戦略
KaliBenchがAIのコマンド生成力を測定
Kali Linux上のコマンド生成力を測る新ベンチマーク「KaliBench」が公開された。ヒントなしの条件では完全一致精度が42%を超えるオープンモデルはなかった。専用の報酬による学習で8Bモデルが685B級に迫った。
494 件
Kali Linux上のコマンド生成力を測る新ベンチマーク「KaliBench」が公開された。ヒントなしの条件では完全一致精度が42%を超えるオープンモデルはなかった。専用の報酬による学習で8Bモデルが685B級に迫った。
Tom Goldstein氏らの研究チームは、球面の潜在空間から画像を生成するオートエンコーダ「Sphere Encoder 2」を発表した。生成の速さと単純さを保ちつつ画質を高め、低コストな画像生成の実用化に寄与する。
実験設計なしで既存データから入力変数の影響度を推定する手法MM-GSAが提案された。二つの指標で変数の重要性を捉え、実務の要因分析や変数選択の精度向上に資する可能性がある。
動画生成AIの物理的な不整合を、物理現象を記述する言語表現の自己改善で抑える枠組みPhysis-Langが提案された。オープンモデルが商用最上位のVeo 3.1を上回り、製造やロボティクスの合成データ活用に影響する。
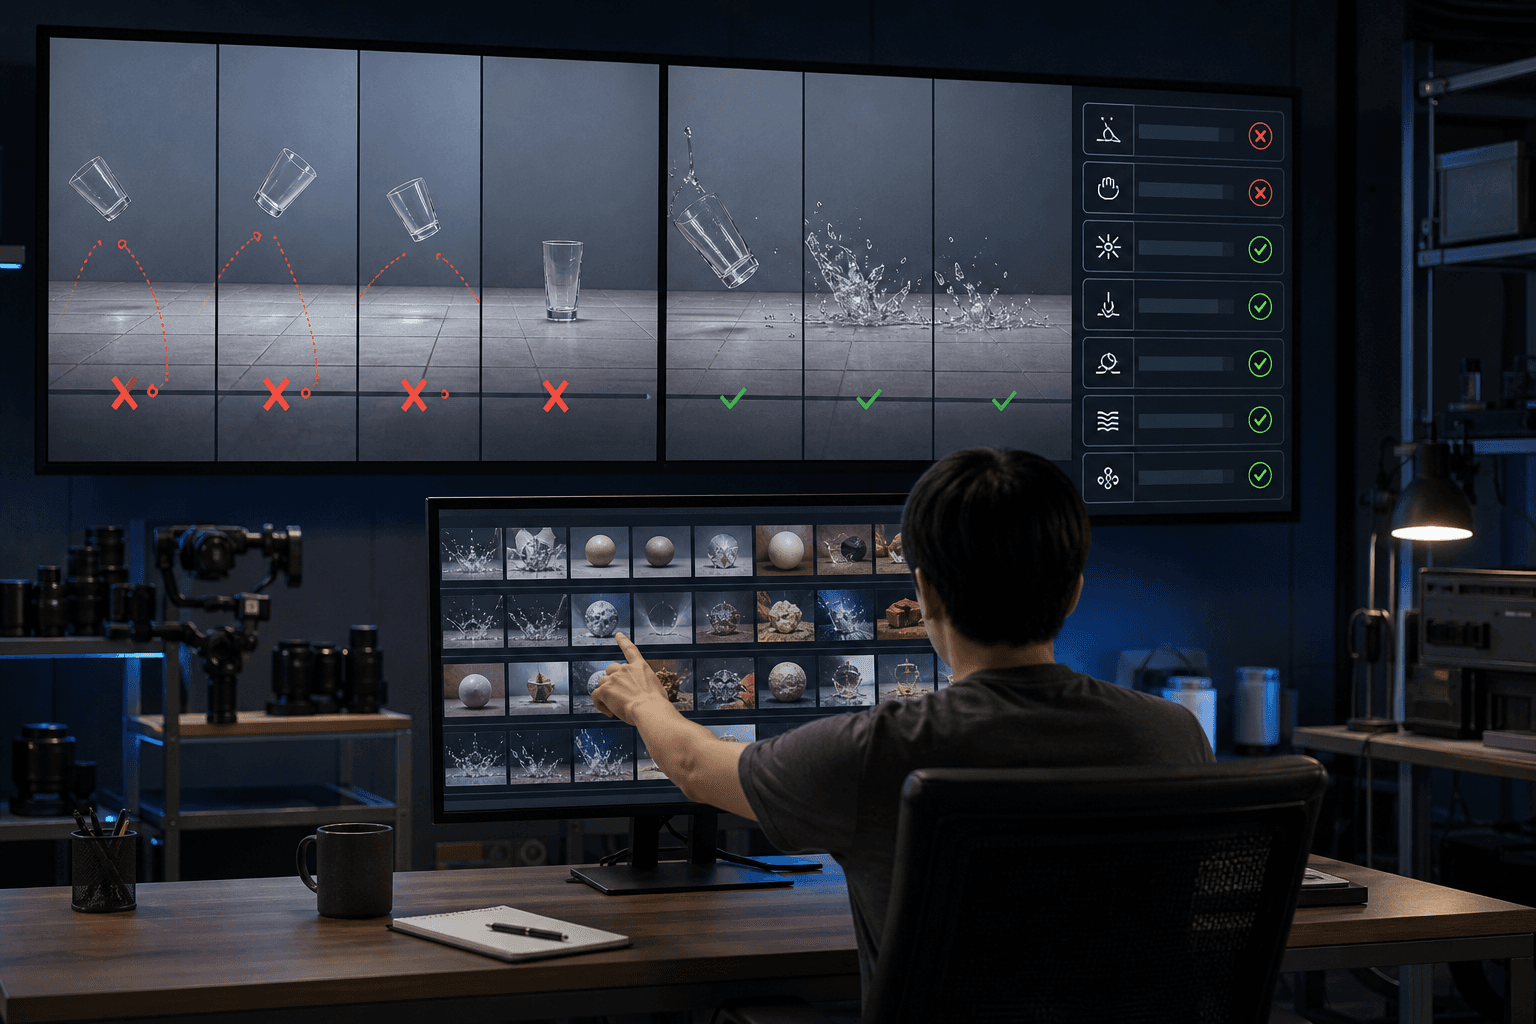
中国の研究チームが、問題の本質と無関係な表現変化に弱いAIの癖を抑える強化学習手法SCAPOを提案した。小型モデルでも数学推論の精度が向上し、業務AIの安定運用に道を開く。
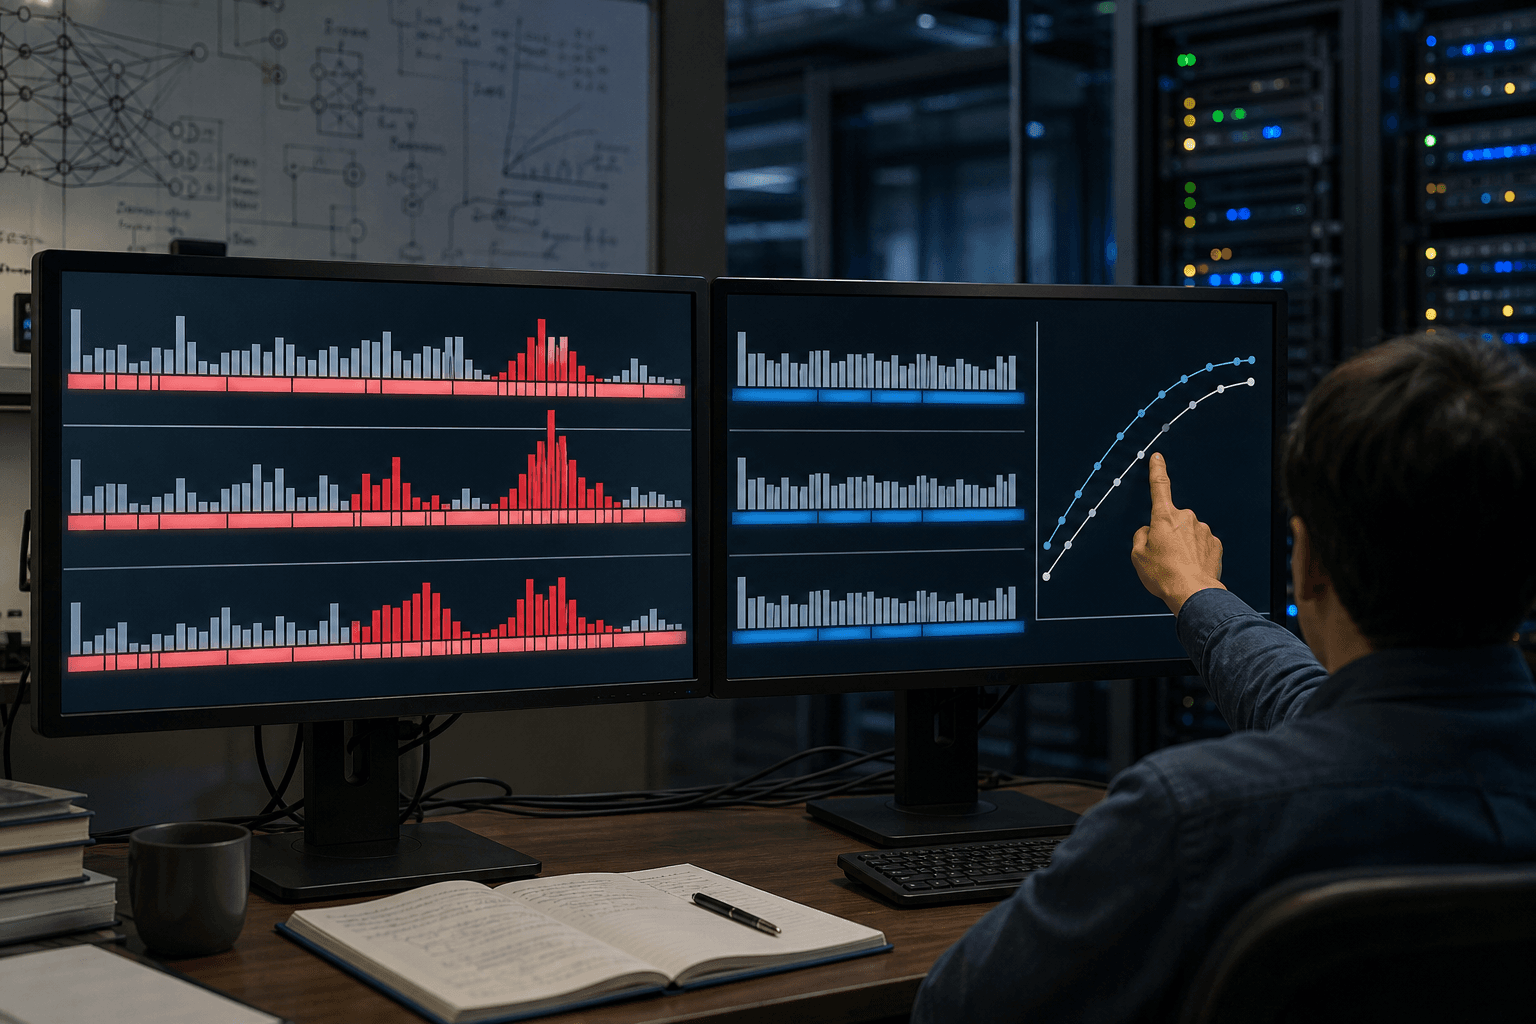
華中科技大学などの研究チームが、言語と画像を連続的な埋め込み空間で一体的に扱う生成モデル「Multimodal Flow」を発表した。1500億トークンの学習で競合に迫り、基盤モデル開発費の抑制につながる可能性がある。
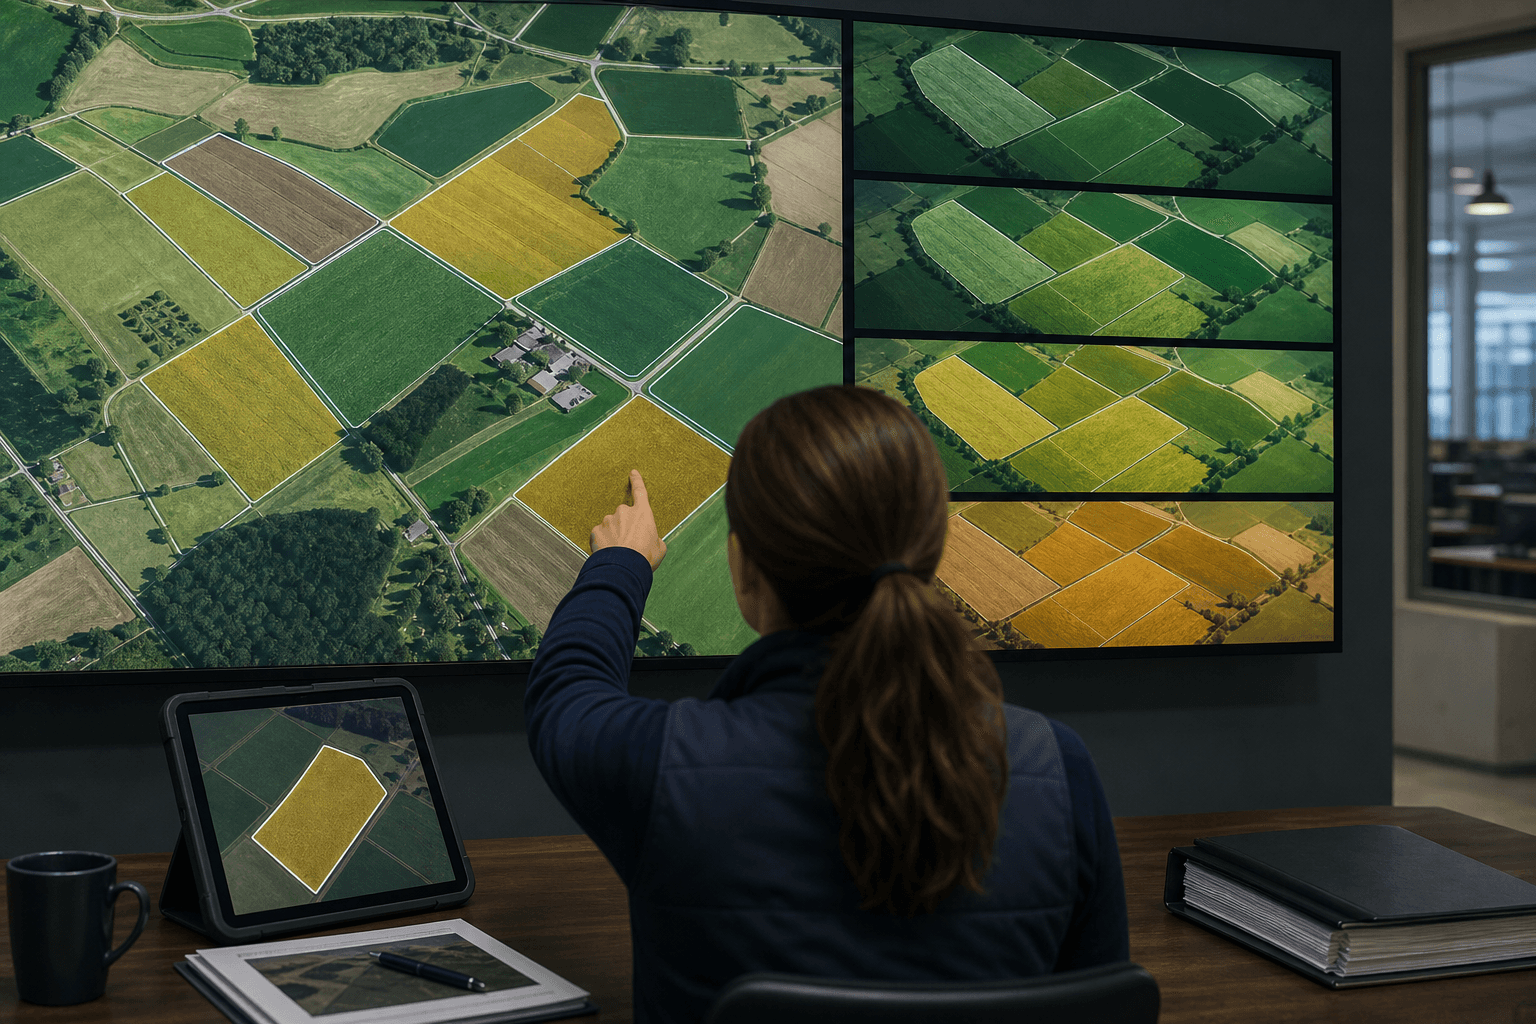
英研究チームは衛星画像の時系列から作物を区分けする新モデル「PAtteRNS」を開発した。主要データで既存手法を上回り、区画境界の精度も高い。データ設計の欠陥も指摘した。
米UCバークレー校などの研究チームが、線形注意型LLMの再帰状態を8ビットに量子化しても精度を保つ手法LeapQuantを開発した。長文推論の費用を下げ、実運用の採算改善に資する成果である。
中国の研究チームは、線形注意モデルの再帰状態を6ビットで圧縮する量子化手法STEPQuantを開発した。精度をほぼ維持し、同時処理時のサービング総メモリを最大68.7%減らす。
生成モデルで意味クラスが確定する時期と、局所的な文脈だけでは生成できなくなる時期が重なる理由を、理論的に証明した研究が登場した。モデル設計や推論効率の指針となる。
韓国の研究チームは、複数視点の画像から粗い3D表現を内部で組み立ててから回答するMLLM「Imagine3D-LLM」を発表した。精密な幾何情報に頼らず、空間推論で既存手法を上回った。
LLMエージェントの実行中にトークン消費量を予測する手法TokenCastが提案された。追加のLLM呼び出しなしで予測を更新し、予算制御でトークンを21.3%削減。運用コストの管理手段として注目される。
研究チームが、登場人物や伏線を構造化して追跡する学習不要の枠組みNstAgentを提案した。10万語規模でも整合性と文章品質が低下せず、出版・映像業界の制作工程に影響し得る。
研究チームが、画像生成AIを1回の推論で動かす学習枠組みMGFlowを発表した。FLUX.2 klein 4Bを1段階化し、4段階の元モデルを主要指標で上回り、生成コスト削減の道を開く。
英研究チームは、1回の学習で全20層の各深度が言語モデルとして機能する「TLM」を提案した。品質と計算量の曲線下面積を43〜44%削減し、学習コストも約12%下げた。
複数のLoRAアダプタを推論コストなしで一つのモデルに統合する新手法READが提案された。新技能は旧技能を読むが書き換えない設計で、SuperGLUEで20点超の改善を示した。
AIが対話相手について抱く暗黙の想定を読み出し、書き換える手法BSDが提案された。拒否判断が利用者像に左右されると示され、AI安全性の管理に影響する。
米研究チームは、内部に触れられない生成AIの出力を、繰り返し問い合わせと選別で属性分布を目標に近づける手法を提案した。クエリ数最小化と漸近最適性も示し、公平性対応やデータ生成の実務に影響する。
逆拡散を用いる生成AIの標本抽出について、データの凸性を仮定しない一次定常性の理論保証を、統計研究者らが示した。品質検証の根拠として産業応用の信頼性向上につながる。
Ene氏とNguyen氏が、ガウス型データ向けに固有値の間隔を仮定しない差分プライバシー付きPCAのアルゴリズムを示した。個人データ分析の適用条件を緩める研究である。