AI×経営戦略
AIエージェント、行動と先読みを同時に学習
イリノイ大学の研究チームは、AIエージェントが次の行動列を先読みする力を行動学習と同時に鍛える手法CoPEを発表した。推論時の負荷を増やさず学習効率を高め、業務自動化の開発コスト低減につながる。
494 件
イリノイ大学の研究チームは、AIエージェントが次の行動列を先読みする力を行動学習と同時に鍛える手法CoPEを発表した。推論時の負荷を増やさず学習効率を高め、業務自動化の開発コスト低減につながる。
静止3Dと動的4Dの空間理解を一つのAIで両立させる枠組み「DynThinker」が登場した。一方を鍛えると他方が劣化する干渉を抑えており、映像解析や現場の安全管理への応用が見込まれる。
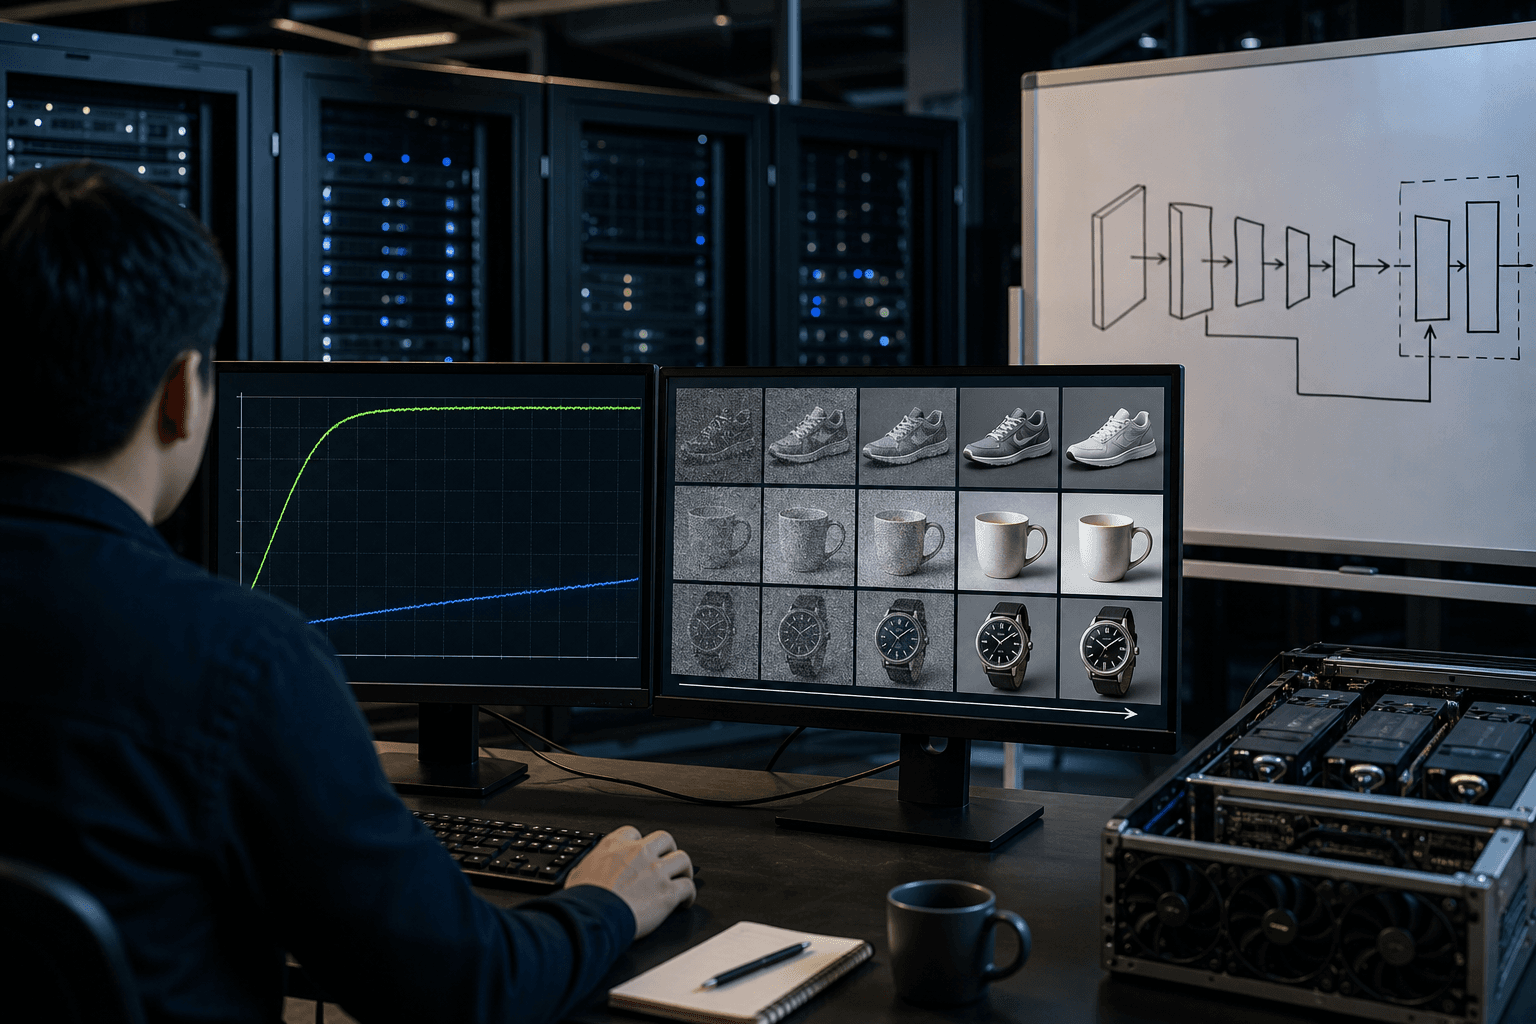
画像生成の拡散モデルで、事前学習済みの視覚エンコーダーの意味情報を後段の層へ直接渡す手法RECONが登場した。追加パラメータなしで、SiT比63倍、REPA比25倍の収束高速化を示し、学習コストの圧縮につながる。
韓国の研究チームは、3D空間への質問応答を同時に学習させると新視点画像の品質と幾何的整合性が高まることを示した。少数の写真から現場を再現する業務の精度向上につながる成果である。
推論AIの長い思考を、追加学習なしで約31%短縮しつつ精度を保つ手法「DoubtLess」が登場した。小型モデルが大型モデルの出力を誘導する仕組みで、推論コストの削減に道を開く。
拡散モデルを学習済みデータなしで訓練する手法が、格子場理論の計算で従来のHMCデータ学習と同等の性能を示した。重い事前サンプリングを省く設計思想は、シミュレーション負荷に悩む産業に波及し得る。
米大学などの研究チームが、長時間の自律作業をこなすAIエージェントを、手順ごとの進捗を報酬にして訓練する手法を発表した。270億パラメータ級のモデルが一部課題で最先端の商用モデルに並び、業務自動化の裾野を広げる可能性がある。
MiniDogは家庭用GPU4枚で、事前学習55分と微調整15分により画像生成モデルを訓練する枠組みである。独自モデルの内製が大企業以外にも現実的な選択肢となる可能性を示した。
単一の行動履歴だけで学ぶQ学習について、最終的に得られる表の精度を保証するデータ量の上界が示された。初期化コストが加算で済むことを証明しており、実運用の見積もり根拠となる。
表形式データの深層学習による回帰で、多くの代替損失はMSEを上回らず、分位点損失だけが一貫して改善した。領域ごとに最適な学習停止時期が異なる点も示された。
視覚言語モデルは画像内の「上」「隣」といった空間関係を、下流で使う文表現の段階で語彙情報より大きく失うことが判明した。出力評価では見えない欠陥である。
研究チームは、予測モデルで次の行動と学習データを選び、AIの方針と予測器を更新し続ける枠組みRSI-Anythingを発表した。外部評価の費用を抑えつつ性能を高める道筋を示した。
カーネル誘導の幾何で見たマルコフ連鎖の収束を、有限標本・高確率の境界で示す研究が登場した。1本の時系列だけで一歩先を予測する学習の速さに保証を与える点が重要である。
間欠的な通信と限られた蓄積容量の下で、どのデータを先に送るかを強化学習で決める枠組みが提案された。情報の鮮度と送信元間の公平性が、従来方式より改善したという。
並列生成で同時に作る箇所を出力ごとに乱数で選ぶと、必要な逐次ラウンド数が対数の二乗から二重対数へ縮むことが理論的に示された。推論の遅延とコストの設計指針となる。
AIモデルの重みの中に暗号化した別のネットワークを隠し、秘密の合図でのみ作動させられることが示された。導入前の能力評価だけでは危険性を見抜けない可能性があり、調達や監査の前提を揺るがす。
ニューラルネットの出力が持つ「穴の数」を表現するのに必要な網の大きさを、数学的に導出した論文が登場した。モデル規模を設計根拠で決める道を開く成果である。
重みや概念ラベルなしで画像AIの判断根拠を概念単位で示す手法HnSが提案された。分類以外の字幕生成や衛星画像分割にも適用でき、AIの説明責任を果たす実務の選択肢が広がる。
異なる構造の画像生成AIの途中経過を共通の潜在空間で受け渡し、生成を引き継ぐ技術InstantFusionが提案された。モデルを再学習せず組み合わせられ、運用の柔軟性を高める。
言語モデルにウィキペディアのリンクだけで目標記事へ到達させる実験で、上位モデルは人間に匹敵した。ただし人間を有意には上回らず、言語や分野で順位が入れ替わる。検索系AIの選定に注意を促す結果である。