ロボ、手本動画を階層で読み成功率向上
LLMが動かすロボットが、手本動画を階層に整理して必要な場面だけ参照する手法が登場した。1本の動画で追加学習なしに成功率を高め、現場導入の負担を下げる点で注目される。
研究の概要
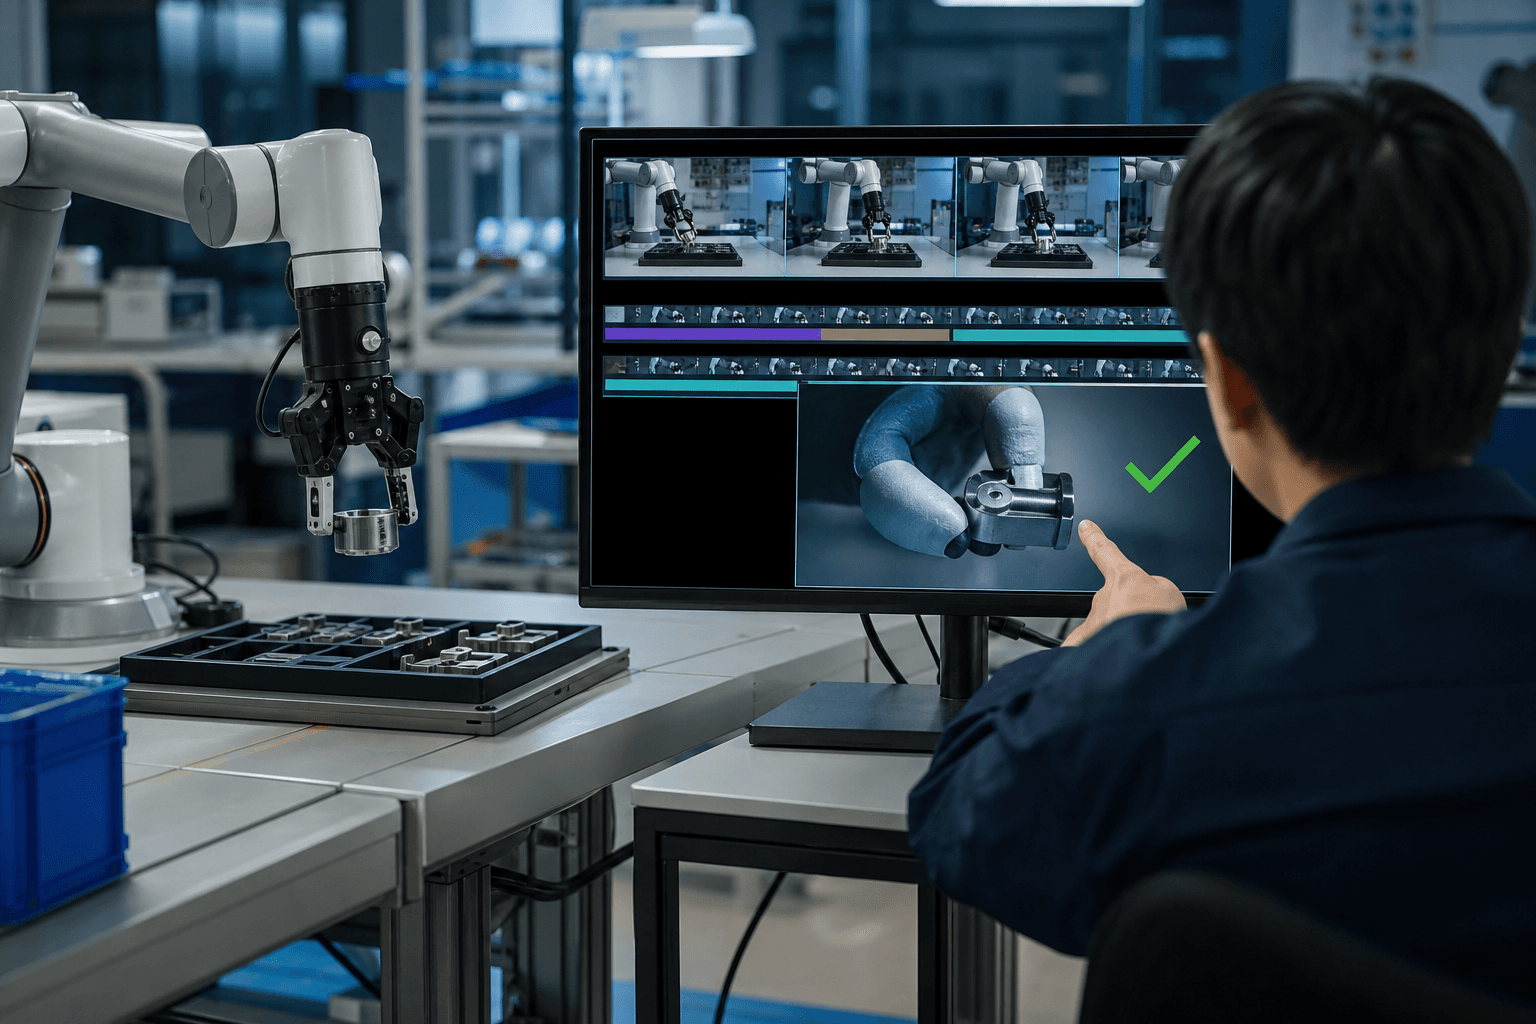
Wenrui Bao氏らの研究チームは、LLMエージェントが既存のロボット制御モデルを操る際に、手本動画を効率よく使う手法「Recursive Video In-Context Learning(RV-ICL)」を発表した。追加の学習を必要とせず、1つの作業につき手本動画が1本あれば機能する。
背景には課題がある。近年は、画像と言語を理解して動作を出力する視覚言語行動(VLA)モデルを固定したまま、LLMエージェントが計画を立てて指示する構成が広がっている。このエージェントは試行を重ねるごとに改善するが、その記憶はテキストであり、何をしたかは残っても作業をどうやるかは残らない。動画ならやり方が伝わるものの、エージェントの文脈にそのまま入れると問題が生じる。動画全体を渡せば毎回の処理が遅くなる。一定間隔で切り出した静止画では、把持が成立するかを左右する接触の細部が失われる。しかも、計画時に必要なのは作業全体の構造であり、実行時に必要なのは各接触の前後のコマであって、求める粒度が局面で変わる。
仕組み
RV-ICLは、動画を「渡すプロンプト」ではなく「エージェントが辿る階層」に変える。つかむ、放すといった動画中のサブイベントを基準に、作業全体のキーフレーム、フェーズ、モーメント、短いクリップの順で粒度が細かくなる構造を作る。各層は読み取り専用のツールとして公開される。
エージェントは計画前に粗い層を読んで作業の流れをつかむ。実行中は、ある手順で詳細が必要になるたびに階層へ戻り、現在のサブゴールに対応するクリップだけを読み込む。必要な情報だけを必要な時に取り出すため、文脈が膨らまない。
RPentを基盤とした評価では、ロボット操作のベンチマークLIBERO-PROで成功率が92.6%から96.5%へ、LIBERO-Plusでは86.7%から95.8%へ向上した。
ビジネスへの示唆
製造業の組立・ピッキング工程が主な適用先である。たとえば、新製品の切替えのたびに、熟練者が実演してロボットの動作を調整し直す作業が発生する。この調整は誰がどれだけ手をかけているのか、自部署で見直す価値がある。RV-ICLは実演動画1本を渡すだけで、細かな持ち方や置き方をロボット側が参照できるようにする発想である。
影響を受けやすい部門と指標は次のとおりである。
- 生産技術部門:ライン切替え時間、立ち上げ工数、再教示の回数
- 品質管理部門:把持ミスや落下による不良率、手直し率
- 物流倉庫:多品種ピッキングの成功率、例外処理にかかる人手
なお、高い成功率は研究用ベンチマーク上の結果である。実際の工場や倉庫は照明、部品のばらつき、安全要件が異なり、同じ水準になる保証はない。自社の作業に近い条件で確かめる必要がある。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:ロボットが失敗しやすい作業と、再教示に人手を取られている作業を洗い出す。失敗が接触の瞬間に集中しているかを確認する。到達点は、効果が出やすい作業の優先順位が現場の共通認識になることである。
-
差し込み先の設計:既存のロボット制御モデルと、LLMエージェントによる作業管理の仕組みを変えず、手本動画の参照層を足す形を優先する。新しい制御系を増やさない。到達点は、既存設備を活かして動画の階層化だけを加える構成の確定である。
-
小さく試す(PoC):1つのラインまたは1種類の作業に絞り、熟練者の実演動画を1本撮って数週間試す。判定は成功率の数字だけでなく、現場担当者が再教示の手間が減ったと実感するかも見る。到達点は、効果と限界が担当者の言葉で説明できる状態である。
-
運用と横展開:動画の撮り方、更新の頻度、失敗時の見直し手順を標準化し、近い作業を持つ他ラインへ広げる。到達点は、新しい作業のたびに実演を1本撮れば立ち上がる運用の定着である。
全体として目指す状態は、熟練者の実演を資産として蓄積し、ロボットの立ち上げと切替えを専門家に頼らず進められる現場である。費用面では、モデルの再学習が不要なため小さく始められる可能性がある。
今後の展望
実演動画を細かな粒度で参照する考え方は、ロボット以外にも応用できる余地がある。作業手順を動画で残す保守点検や、技能伝承の分野である。一方で、実機での検証、動画撮影の標準化、誤動作時の責任分界など、実用化には課題が残る。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
人型ロボ、自己進化で動作を拡張
人の動作データを人型ロボットの実行可能な動作へ変換し、成功した変種だけを再学習に回す枠組み「InterMimicGen」が提案された。少量の実演から作業の網羅範囲を広げる道筋を示す。
視線制御ロボ、手首カメラなしで精密作業
米研究チームは人間の視覚に倣い、単一のステレオカメラの視線を能動制御して両手作業を行うロボット手法を発表した。手首カメラを省きつつ成功率を維持し、ロボットの低コスト化に道を開く。
動的場面のコード再現、AIに壁
動画から物理現象を再現するグラフィックスコードをAIに書かせる新指標「4DCodeBench」が公表された。静的再現に強い先端モデルも、変形や流体の動的再現は不安定と判明した。