ギャップ不要の秘匿PCA、ガウスデータで実現
Ene氏とNguyen氏が、ガウス型データ向けに固有値の間隔を仮定しない差分プライバシー付きPCAのアルゴリズムを示した。個人データ分析の適用条件を緩める研究である。
研究の概要
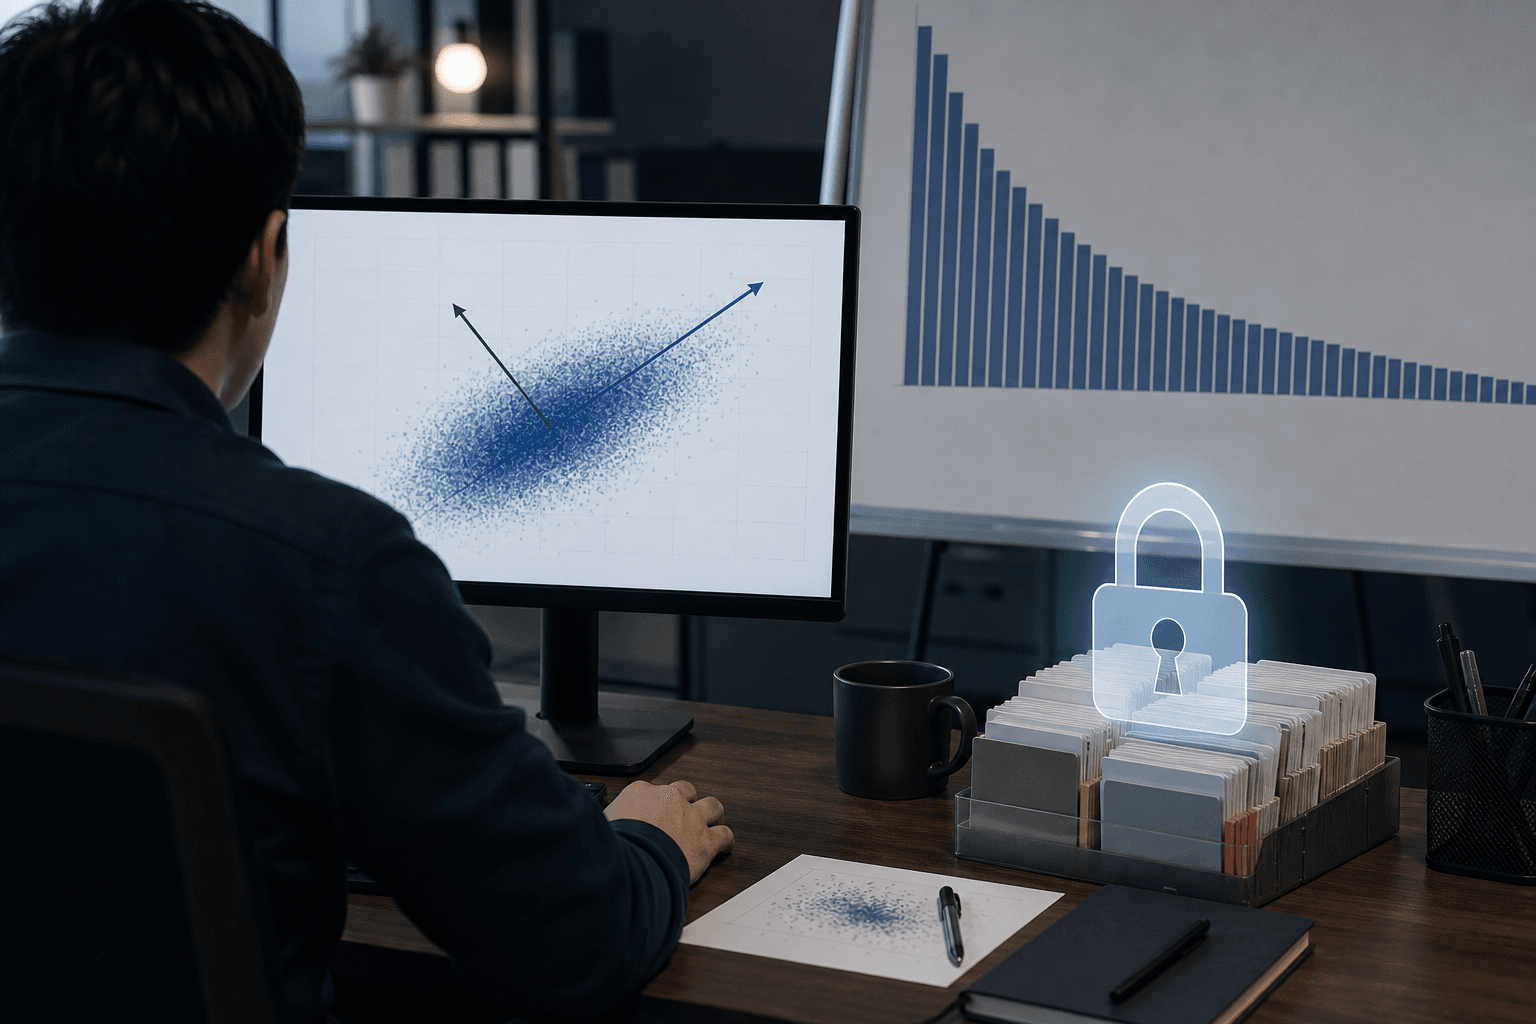
Alina Ene氏とHuy L. Nguyen氏は、ガウス分布に従うデータを対象に、ギャップフリーな差分プライバシー付き主成分分析(PCA)アルゴリズムを提案した。arXivに公開された論文の要旨は一文のみである。そのため、精度の改善幅、必要なサンプル数、計算量といった具体的な数値は、要旨からは確認できない。
差分プライバシーは、分析結果から特定の個人のデータが含まれていたかどうかを推測しにくくする数理的な保証である。PCAは高次元データを少数の軸に要約する基本手法であり、顧客分析、異常検知、機械学習の前処理などに広く使われている。
従来の差分プライバシー付きPCAの理論保証は、データの共分散行列における固有値の間隔(固有ギャップ)が十分に大きいことを前提とするものが多い。ギャップフリーとは、この前提に依存しない保証を指すのが一般的である。実務データでは固有値が連続的に減衰し、明確な間隔がない場合が珍しくない。この条件を外せる点が、今回の研究の理論的な意義である。
ビジネスへの示唆
影響が見込まれるのは、個人データを扱う次の業種である。ただし、本研究は理論的な成果であり、実装や実データでの検証結果は要旨に示されていない。導入の可否は、今後の追試や実装の公開を待って判断する必要がある。
- 金融:与信・不正検知の特徴量圧縮。リスク管理部門が再現率と誤検知率を維持できるかが焦点になる
- 医療・ヘルスケア:患者記録やゲノム情報の次元削減。研究部門が施設間でデータ提供を受ける際の同意取得率に関わる
- 小売・マーケティング:購買履歴に基づく顧客セグメンテーション。分析部門の施策精度とプライバシー水準の両立が課題である
- 通信・モビリティ:位置情報や利用ログの傾向分析
法務・コンプライアンス部門にとっては、差分プライバシーの強さを示す**プライバシー予算(ε)**が、監査や説明責任の定量的な根拠になり得る。個人情報保護法や欧州のGDPRへの対応では、匿名化の妥当性を説明する工数が負担となっている。数理的な保証を持つ手法は、この工数の削減に寄与する可能性がある。
データサイエンス部門にとっては、固有ギャップの有無を事前に検証する手間が減る可能性がある。データの性質を見極める前処理の工程が短くなれば、分析着手までのリードタイムの短縮につながる。
今後の展望
本研究の対象はガウスデータに限られる。実際の業務データは裾の重い分布や欠損を含むことが多く、成果をそのまま適用できるとは限らない。分布の仮定を緩めた場合の保証や、大規模データでの計算効率が、次の検証課題となる。
企業がまず取り組むべきは、自社のデータがガウス分布でどの程度近似できるかの評価と、PCAを用いる分析工程の棚卸しである。プライバシー保護型の分析は、データの共有や外部連携を進める際の前提条件になりつつある。理論の進展を実務へ橋渡しする体制を整えておくことが、競争力の維持につながる。
関連トピック
同セクションの記事
LoRA合成の干渉を新手法READが解消
複数のLoRAアダプタを推論コストなしで一つのモデルに統合する新手法READが提案された。新技能は旧技能を読むが書き換えない設計で、SuperGLUEで20点超の改善を示した。
LLM内部の利用者像を可視化し書換え
AIが対話相手について抱く暗黙の想定を読み出し、書き換える手法BSDが提案された。拒否判断が利用者像に左右されると示され、AI安全性の管理に影響する。
生成AIの出力属性を後処理で目標分布に整合
米研究チームは、内部に触れられない生成AIの出力を、繰り返し問い合わせと選別で属性分布を目標に近づける手法を提案した。クエリ数最小化と漸近最適性も示し、公平性対応やデータ生成の実務に影響する。