LLM内部の利用者像を可視化し書換え
AIが対話相手について抱く暗黙の想定を読み出し、書き換える手法BSDが提案された。拒否判断が利用者像に左右されると示され、AI安全性の管理に影響する。
研究の概要
ドイツのAI研究者らは、大規模言語モデル(LLM)が対話相手の属性や意図を内部で推定し、応答を変えている実態を、直接検査し操作できる形で取り出す手法「信念自己蒸留(BSD)」を発表した。論文はプレプリントサーバーarXivで公開されている。
LLMは利用者の専門性や目的を暗黙のうちに推測して振る舞いを調整するとされるが、その推測内容は外から確認しにくく、因果的な検証も難しかった。従来の線形プローブは内部状態に情報が存在するかを調べるにとどまり、その情報が実際の挙動に効いているかは示せなかった。
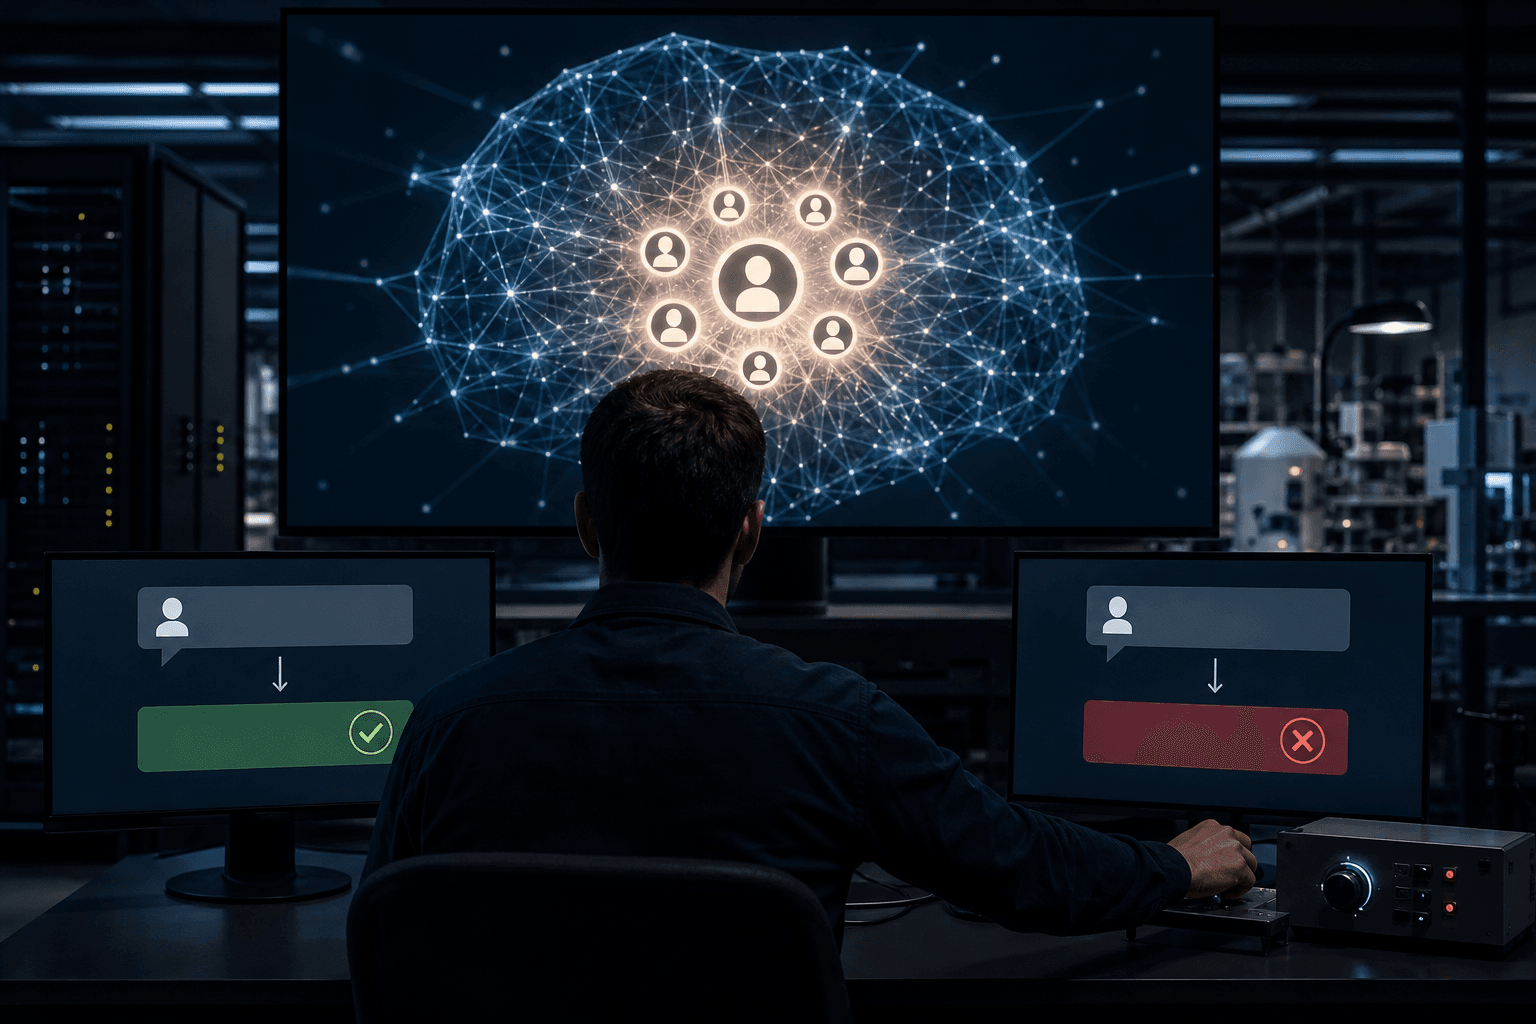
BSDは、重みを固定したLLM自身を教師とし、外部の注釈データなしに自然な会話から利用者像を蒸留する。得られる小さな表現は、内部状態から読み出せるだけでなく、モデルへ書き戻して挙動を変えることもできる。読み書き両方に使える点が特徴である。
複数のモデルファミリーで検証した結果、BSDは利用者に関する信念を忠実に復元した。さらに、同等条件の隠れ状態ステアリングと比べて大幅に強い介入が可能だった。
最も注目されるのは拒否判断への影響である。要求文を固定したまま、モデルが推定する利用者の意図だけを書き換えると、拒否するか否かが変化した。拒否は要求の内容だけでなく、モデルが想定する相手の意図にも依存することになる。加えて、独立に訓練された複数のLLMが、利用者を表す共通の幾何構造に収束する傾向も確認された。
ビジネスへの示唆
最も影響を受けるのは、金融、医療、法務など規制産業でAIを顧客対応や社内業務に導入する企業である。これらの現場では、利用者の属性推定が回答の範囲や拒否判断を左右している可能性がある。同じ質問でも、相手を専門家と見なすか一般消費者と見なすかで応答が変わりうる。
各部門で想定される活用は次のとおりである。
- リスク管理部門:利用者像の推定を監査項目に加え、不適切な拒否や過剰な許可の発生率を点検する
- コンプライアンス部門:属性による応答差を可視化し、公平性の説明資料に用いる
- カスタマーサポート部門:誤った拒否による問い合わせ放棄率や解決率を改善指標とする
- AI開発部門:レッドチーミングで、利用者像の操作による安全策の突破可能性を検証する
同時に、リスクも明確になる。利用者像が拒否判断を動かすなら、攻撃者が「正当な専門家」と誤認させることで安全策を回避する経路が生じうる。逆に、正当な利用者が不当に疑われ、業務が止まる誤拒否も起こりうる。前者は不正利用の検知件数、後者は業務完了率や顧客満足度に直結する。
共通の幾何構造という知見は、モデル間で監査手法を流用できる可能性を示す。複数ベンダーのLLMを併用する企業にとって、評価コストの抑制につながりうる。ただし、この点は今後の追試による裏づけが必要である。
今後の展望
実務での適用には課題が残る。BSDは内部状態へのアクセスを前提とするため、重みが非公開の商用APIには直接使えない。自社でモデルを運用する、あるいはオープンモデルを採用する企業が当面の対象となる。
また、利用者像を書き換える技術は、安全性の検証にも悪用にも使える両面性を持つ。導入企業には、内部状態の監査権限や介入手順を定める社内規程の整備が求められる。モデル提供者が利用者像の開示や監査機能を備えるかどうかは、今後の調達基準になりうる。
AIが相手をどう理解しているかを測る指標が確立すれば、安全性評価は入力と出力の検査から、内部の判断根拠の検査へ広がる。規制当局の監督や第三者監査の在り方にも影響を与える可能性がある。
関連トピック
同セクションの記事
LoRA合成の干渉を新手法READが解消
複数のLoRAアダプタを推論コストなしで一つのモデルに統合する新手法READが提案された。新技能は旧技能を読むが書き換えない設計で、SuperGLUEで20点超の改善を示した。
生成AIの出力属性を後処理で目標分布に整合
米研究チームは、内部に触れられない生成AIの出力を、繰り返し問い合わせと選別で属性分布を目標に近づける手法を提案した。クエリ数最小化と漸近最適性も示し、公平性対応やデータ生成の実務に影響する。
逆拡散の理論保証、凸性なしで確立
逆拡散を用いる生成AIの標本抽出について、データの凸性を仮定しない一次定常性の理論保証を、統計研究者らが示した。品質検証の根拠として産業応用の信頼性向上につながる。