生成AIの出力属性を後処理で目標分布に整合
米研究チームは、内部に触れられない生成AIの出力を、繰り返し問い合わせと選別で属性分布を目標に近づける手法を提案した。クエリ数最小化と漸近最適性も示し、公平性対応やデータ生成の実務に影響する。
研究の概要
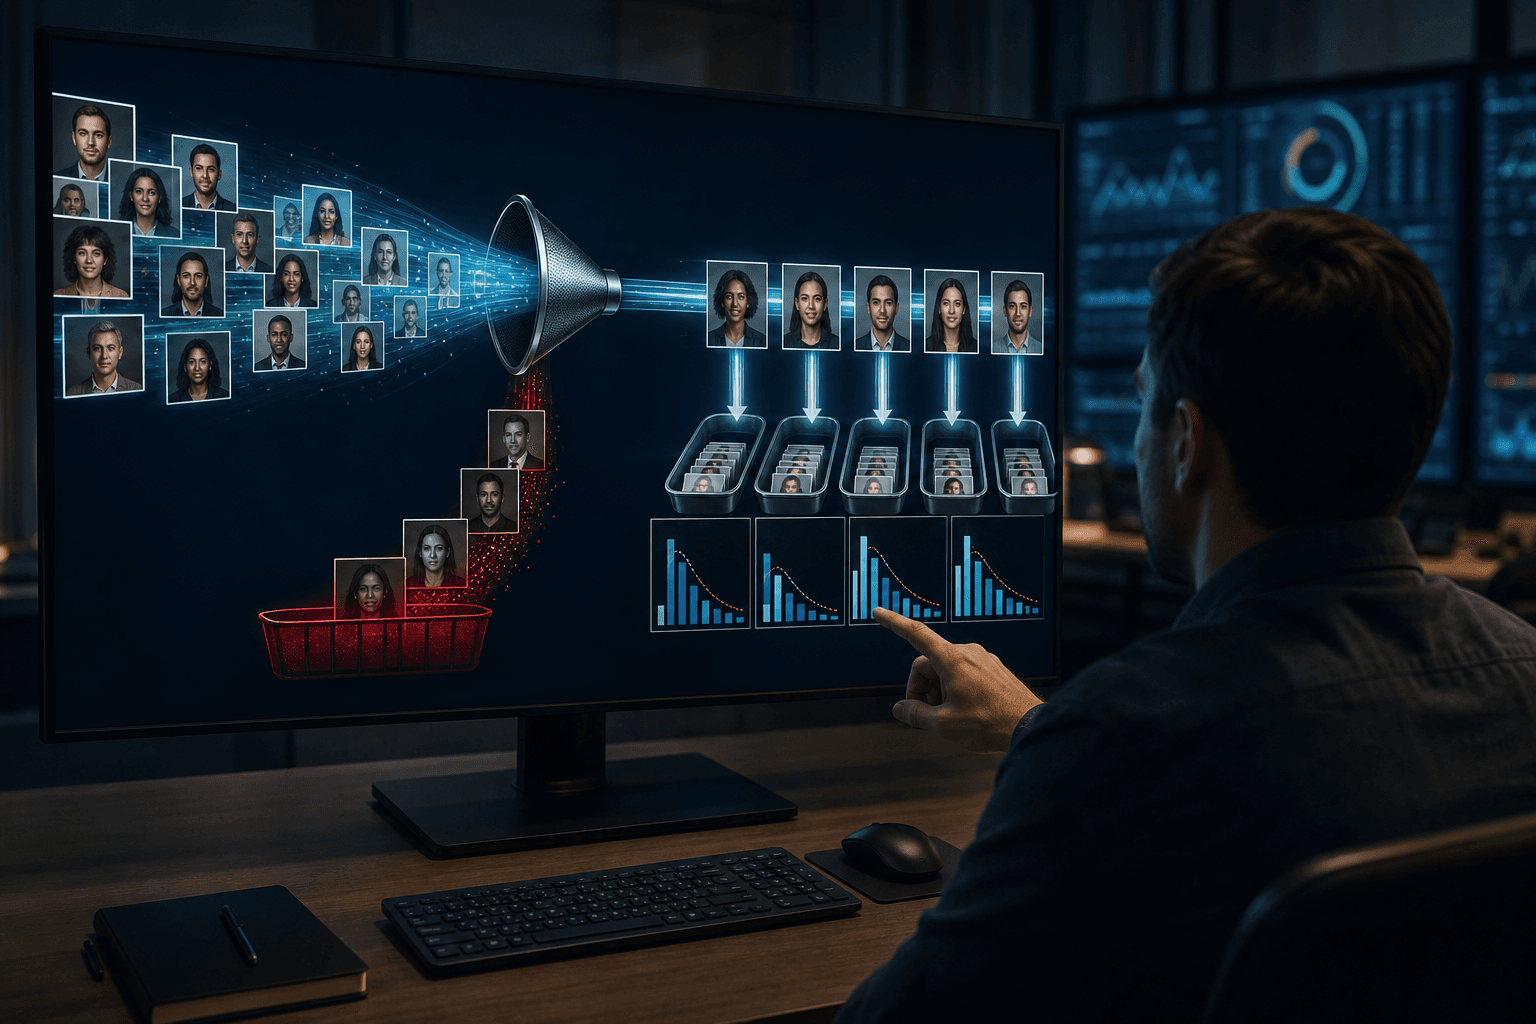
Kevin Jiang氏、Morgane Austern氏、Edgar Dobriban氏、Jason M. Klusowski氏らの研究チームは、生成AIの出力に含まれる属性の分布を、利用者が指定した目標分布に整合させる後処理アルゴリズムを発表した。論文はarXivで公開されている。
対象は、モデルの内部や重みに触れられず、繰り返し問い合わせることしかできない「ブラックボックス」環境である。企業が外部のAPI経由で生成AIを利用する場面は多く、実務に即した設定といえる。
研究の目的は、m個(mは1以上)の出力を返す際に、それらの属性の同時分布を目標にできるだけ近づけることである。属性としては、性別、人種、年齢層といった保護属性が想定される。あわせて、合成データを目標とする母集団の構成に合わせる用途も念頭に置く。
提案手法は、生成器への期待クエリ数を最小化するよう設計されている。厳密な整合と近似的な整合の双方についてアルゴリズムを構築し、要求する出力数mが無限大に近づく場合に、その手法が最適であることを理論的に示した。
実験はテキストから画像を生成するタスクと、地理情報付きのペルソナ生成タスクで実施された。その結果、後処理アルゴリズムは統計的な属性整合を改善し、プロンプトの工夫による従来の介入を補完することが確認された。
ビジネスへの示唆
最大の特徴は、モデルの再学習や微調整を要せず、出力側で分布を制御できる点である。外部ベンダーのモデルを利用する企業でも、自社の運用層で導入しやすい。影響が見込まれる領域と指標は次のとおりである。
- 広告・マーケティング部門:生成画像や訴求コンテンツにおける人物属性の偏りの是正。ブランドリスクの低減と、ターゲット層との表象の一致度の向上
- 市場調査・商品企画部門:地域別の人口構成に合わせた合成ペルソナの生成。サンプルの代表性や調査設計の再現性の向上
- 人事部門:採用広報資料や研修教材の生成物における属性バランスの管理。公平性監査への対応工数の削減
- 金融・保険部門:合成データを用いたモデル検証における、顧客構成の再現精度の向上
プロンプトの工夫だけでは、出力の属性分布を保証することが難しい。本手法は統計的に目標分布へ近づける仕組みを提供するため、コンプライアンス部門や法務部門にとっては、公平性への取り組みを定量的に説明する材料となり得る。
一方で、後処理は出力の選別や再生成を伴うため、追加のクエリが発生する。API従量課金の環境では、1件あたりの生成コストと応答時間が新たなKPIとなる。本研究が期待クエリ数の最小化を掲げている点は、コスト面の懸念を和らげる。
今後の展望
生成AIの利用が広がる中、出力の公平性や代表性を求める規制や社会的要請は強まる傾向にある。ブラックボックス環境で使える後処理型の整合手法は、モデル提供者に依存しない統制手段として位置付けられよう。
実装にあたっては、属性を判定する分類器の精度が結果を左右する。属性の推定誤差や、複数属性を同時に扱う際の計算負荷など、運用上の課題は残る。実験も画像生成とペルソナ生成の2タスクに限られ、他の領域での有効性は今後の検証を要する。
企業にとっては、プロンプト設計による前段の制御と、後処理による統計的な保証を組み合わせる二層の運用が現実的な選択肢となる。生成AIのガバナンス体制を整える上で、実務への応用が注目される。
関連トピック
同セクションの記事
LoRA合成の干渉を新手法READが解消
複数のLoRAアダプタを推論コストなしで一つのモデルに統合する新手法READが提案された。新技能は旧技能を読むが書き換えない設計で、SuperGLUEで20点超の改善を示した。
LLM内部の利用者像を可視化し書換え
AIが対話相手について抱く暗黙の想定を読み出し、書き換える手法BSDが提案された。拒否判断が利用者像に左右されると示され、AI安全性の管理に影響する。
逆拡散の理論保証、凸性なしで確立
逆拡散を用いる生成AIの標本抽出について、データの凸性を仮定しない一次定常性の理論保証を、統計研究者らが示した。品質検証の根拠として産業応用の信頼性向上につながる。