時系列AI、二つの視点を併用し精度向上
線グラフと遅延埋め込みの二種類の画像を併用する時系列推論モデルが、TSRBenchの精度を44.5%から53.2%へ高めた。センサーや売上の推移を言葉で読み解くAIの設計指針を示す成果である。
研究の概要
イスラエルの研究チームは、時系列データを言語モデルに理解させる「時系列言語モデル(TSLM)」について、新たな設計原則を提案した。従来のTSLMは、言語モデルに単一の表現しか与えないため、どのタスクにも同じ前提を押し付ける構造であった。研究チームは、この単一表現が情報の保持と捨象の両面で偏りを生むと指摘する。
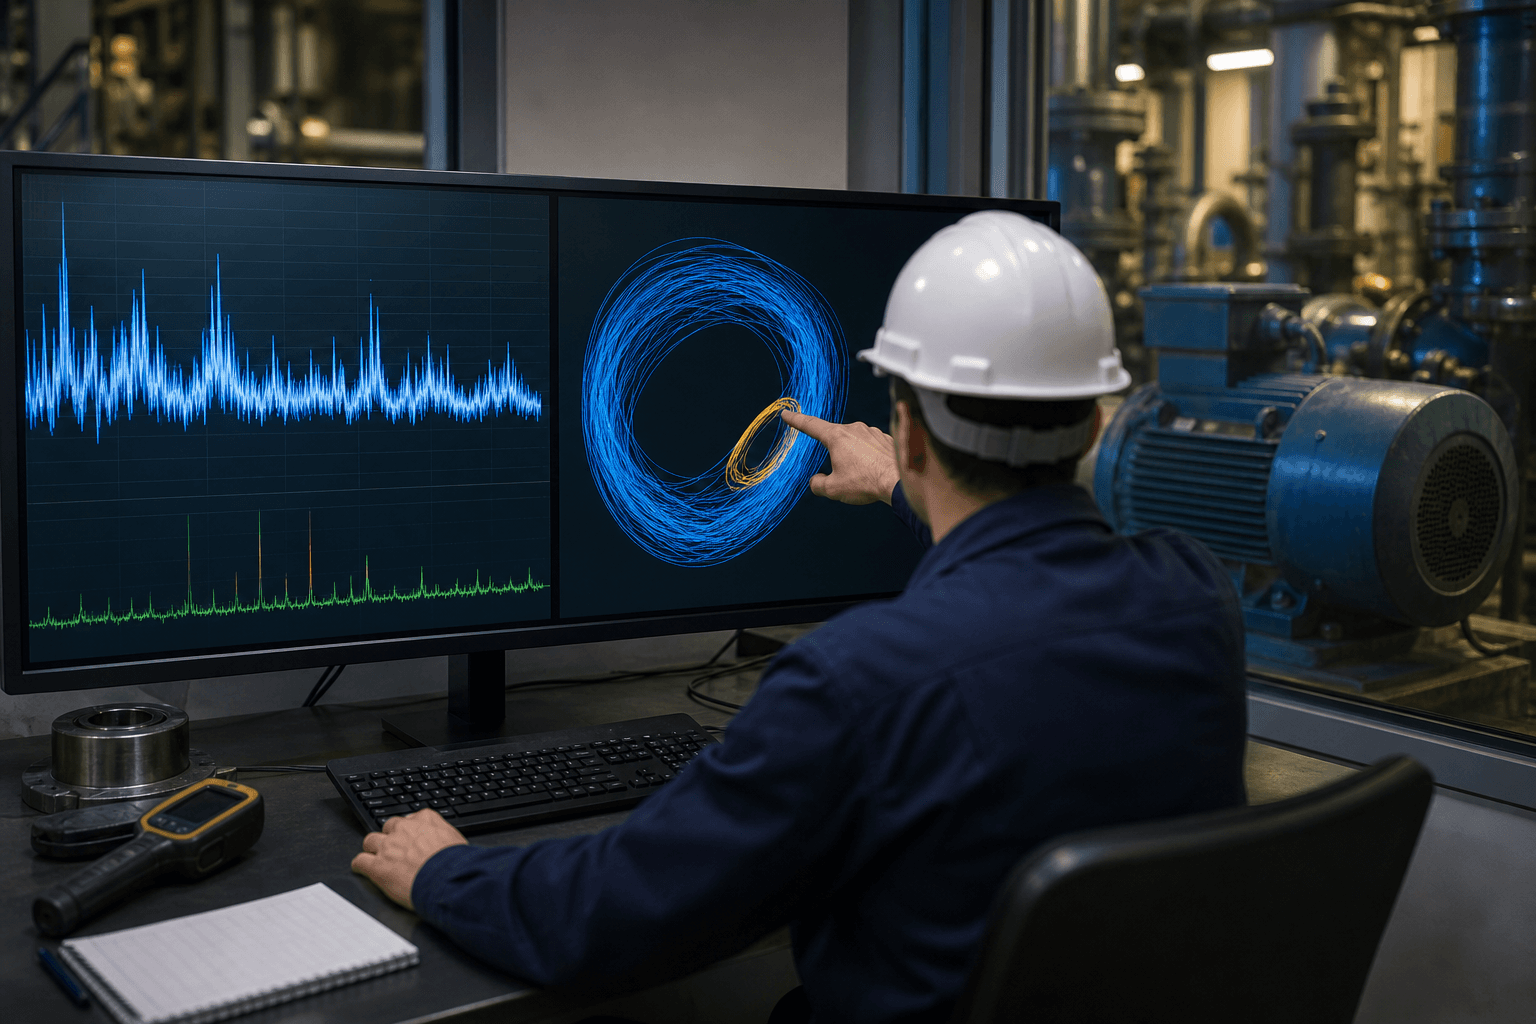
提案は、性質の異なる二つの表現を相補的に併用する「補完的表現」である。一つは、絶対的な数値と座標軸を保つ折れ線グラフ。もう一つは、振幅の拡大縮小や平行移動の影響を取り除きつつ時間構造を浮かび上がらせる、正規化した遅延埋め込みの画像である。
Qwen3-VL-8Bを基盤とした二視点モデルは、TSRBenchの総合精度で線グラフのみの44.5%から53.2%へ向上した。評価対象の専用TSLMで最良の36.7%も大きく上回る。さらにTSExamで89.9%、多変量のChatTS整合では数値精度86.8%を記録した。単一視点を除く実験では、基本的な知覚よりも予測と推論で併用の効果が大きかった。
しくみをやさしく
遅延埋め込みとは、時系列の現在値と少し前の値を組にして座標上に点を描く手法である。たとえば「今日の気温」と「昨日の気温」を縦横の軸に取って点を打てば、周期的に変動するデータは輪の形、不規則なデータは散らばった形になる。波形の繰り返しや状態の遷移といった構造が、形として見えるようになる。
この画像は正規化されているため、同じ動きであれば値の大小や基準値の違いに左右されない。一方で、その代償として「実際にいくつだったか」という絶対値の情報は失われる。そこで、絶対値と座標の基準を保持する折れ線グラフを並べて与え、欠点を互いに補う。
二つの画像は、それぞれ専用の視覚エンコーダで処理され、視覚トークンとして共通の言語モデルに入力される。複数階層の特徴を融合する仕組みも備える。評価時に振幅や平行移動といった操作を加える実験では、二つの視点が異なる不変性を示すことが確認された。
ビジネスへの示唆
恩恵が大きいのは、時系列を見て判断や説明を書く業務である。製造部門では、設備の振動やモーターの電流波形を保全担当者が目視で点検し、異常の兆候を報告書にまとめている。需要予測を担う営業企画や物流部門では、売上や出荷量の推移から季節性と一時的な変動を切り分ける作業が毎週発生する。
自部署で、グラフを見て文章で所見を書く業務は何か。それに誰が、週にどれだけの時間を割いているか。この問いに答えられれば、適用先の候補が見えてくる。
動きていく指標は次のとおりである。
- 製造・保全:異常検知までの時間、点検報告書の作成工数、見逃し率
- 需要予測・SCM:予測の説明に要する工数、在庫回転、欠品率
- 金融・財務:レポート作成の所要時間、市場や資金繰り推移の解釈の一貫性
- ヘルスケア:生体信号の経過観察に要する看護・臨床側の負担
絶対値を見る視点と形を見る視点を併せ持つことは、人間の熟練者の読み方に近い。「水準は正常だが波形の癖が変わった」といった判断を、AIが言語で説明できる可能性がある。なお、論文の数値はベンチマーク上の結果であり、自社データでの効果は別途の検証が必要である。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:グラフや波形を見て判断・報告している業務を洗い出し、担当者、頻度、判断が属人化している箇所を可視化する。到達点は、効果が出やすい業務と、現状の手間・待ち時間が一覧できる状態である。
-
差し込み先の設計:新しいツールを増やさず、既存の監視ダッシュボードや報告書の作成フローに載せる。時系列を折れ線と遅延埋め込みの二枚の画像に変換する処理を前段に置き、結果を既存の画面に所見として返す形が現実解である。到達点は、担当者の作業動線を変えずにAIの所見を参照できる状態である。
-
小さく試す(PoC):一部署、数週間の範囲で、過去の事例を使い、AIの所見と熟練者の判断を並べて比較する。到達点は、担当者が「使える・使えない」を実感で判断でき、誤りの傾向を把握できる状態である。
-
運用と横展開:所見の確認基準、人が最終判断する範囲、機密データの扱いを定め、他の設備や部署へ広げる。到達点は、属人的な読み取りの技能が組織の標準手順として共有される状態である。
全体として目指すのは、熟練者の時系列の読み方を言語化して共有し、点検や報告にかかる手間を減らせる職場である。小さく・安く始められる点は、80億パラメータ規模の公開モデルを基盤とする本研究の利点である。
今後の展望
今回の成果は、表現の選び方そのものがモデル性能を左右することを示した。今後は、画像以外の表現との組み合わせや、より長大な時系列、業界固有のデータでの検証が焦点となる。企業側には、時系列をどの視点で見せるかという設計の発想が求められる。
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
Dense4D、人の動きを画素単位で追跡する
単眼のRGB画像から、服や髪を含む人体表面の同一点を3次元で追う新モデルDense4Dが登場した。体型テンプレートなしで高い追跡精度を示し、映像制作や動作評価の工程を変える可能性がある。
ロボ、人の遊びから器用さを自習する
米研究チームは、人間の数分の「遊び」を手本にロボットが接触データを自力で集め、器用な手作業を学ぶ枠組みDSPを発表した。強化学習と同等の成功率を490分の1のデータで達成した。
3D制作をコード化するAI基盤が登場
3DCodeVerseは、編集と検証が可能な3Dコンテンツをコーディングエージェントが大量生成する基盤である。200万件規模のデータと自動検証の仕組みを備え、3D制作の内製化を後押しする可能性がある。