スマホ撮影だけでロボを現場適応させる技術
スマートフォンによる室内スキャンだけで、汎用ロボット制御AIを個別の現場に適応させる手法が登場した。実機での把持成功率は63.9%に達し、現場ごとの実演収集コストを抑える道を開く。
研究の概要
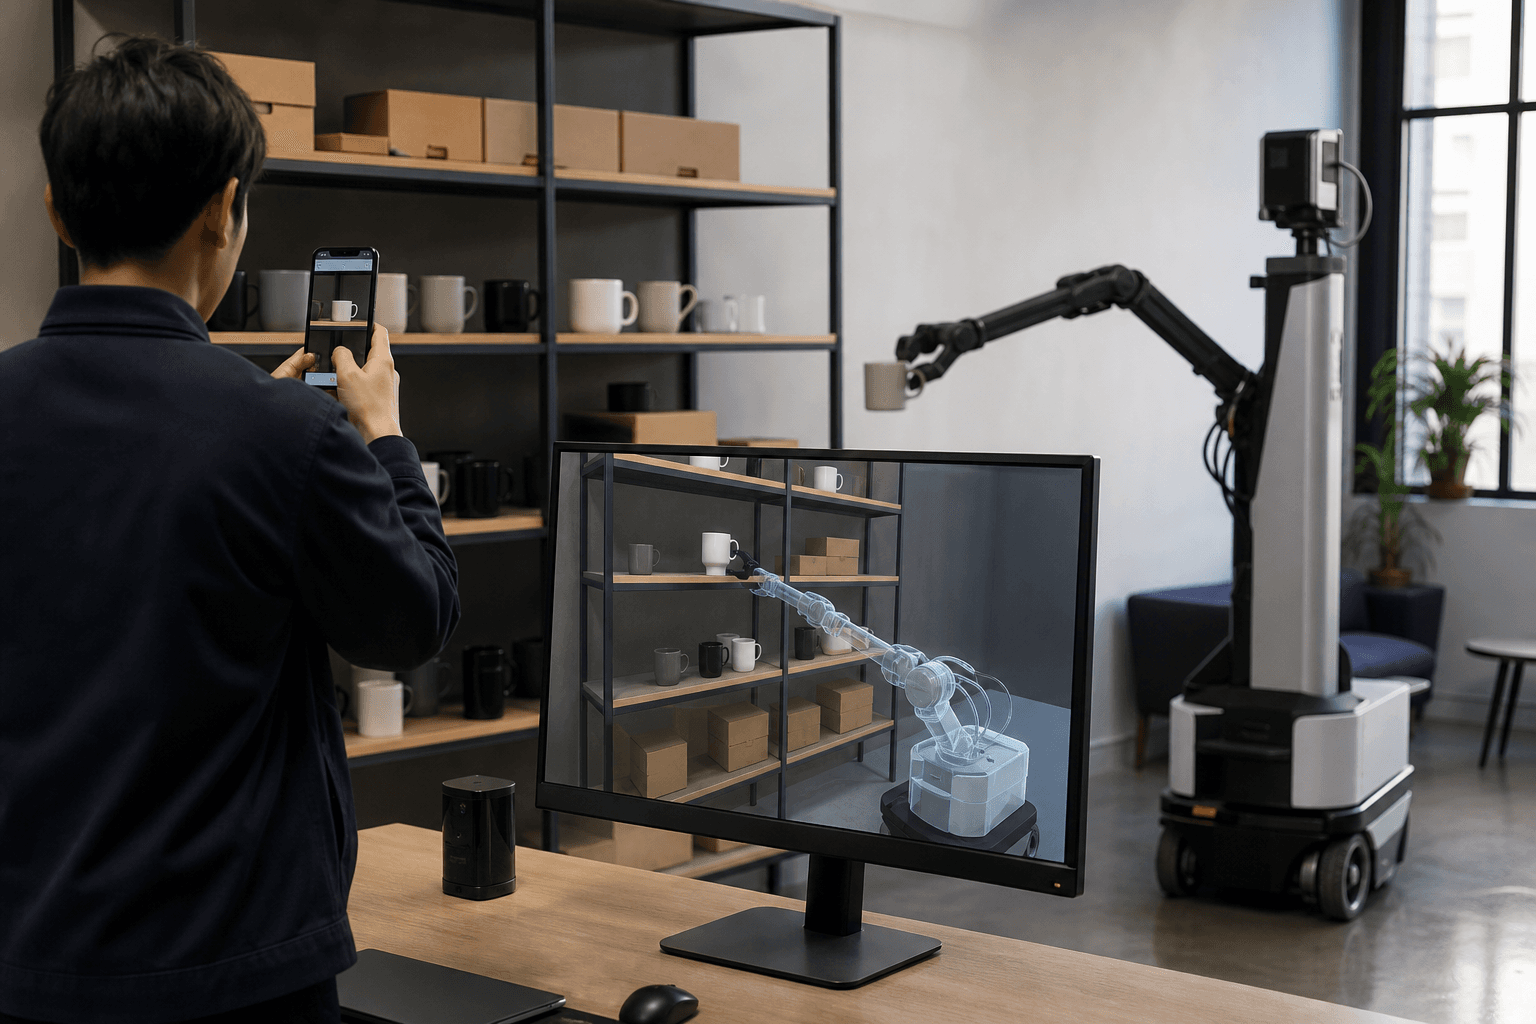
ジョージア工科大学などの研究チームは、手持ちのスマートフォンで撮影した室内映像から、特定の現場に合わせてロボットの制御AIを個別最適化する自動パイプライン「Splat2Act」を発表した。対象は、視覚・言語・行動を一体で扱うVLA(視覚言語行動)モデルの一種「π0.5」である。論文によれば、この強力な汎用モデルでさえ、撮影した導入先の場面では事前の適応なしでは物体の拾い上げ成功率が0%であった。
Splat2Actは建物規模の屋内環境を扱う点が特徴である。従来の実世界から仿真への研究は机上の小さな範囲の再現が中心であった。今回は大学キャンパスの101環境(ナビゲーション可能面積の中央値104.87平方メートル、棚や机などの置き場所の中央値7か所)に適用し、852の置き場所と6万8000件を超える拾い上げの実演データを生成した。
学習は二段階で行う。第1段階では数百の公開物体データに適応し、導入先1場面のみ、または全101場面のいずれかから学習する。第2段階では利用者自身の物体に個別化する。最良の個別化モデルは対象場面で総合62.5%の成功率に達した。実機ロボット「Stretch 3」では12課題の部分集合で63.9%を記録し、同条件のシミュレーション成功率66.7%と近い値となった。
しくみをやさしく
中核は、現実の部屋を仮想空間に写し取り、そこでロボットの練習データを自動生産する流れである。まず、スマートフォンで部屋を撮影し、3Dガウシアンスプラッティングと呼ばれる手法で写真のように見える3Dモデル(デジタルツイン)を作る。あわせて、ロボットが物にぶつかる判定に使う衝突用の形状も生成する。
次に、この仮想空間から机の上だけでなく棚など机以外の置き場所も自動で見つけ出し、実際に拾える課題を組み立てる。その後、仮想空間だけが知り得る正確な情報、すなわち物体の位置や形状を使う「特権的な教師役(オラクル)」が、成功する動作を自動で生成する。人間が操作して見本を示す必要はなく、人が行うのは部屋と物体の撮影のみである。
こうして得た大量の成功例でVLAモデルを追加学習させる。人間が現場で何百回も見本を示す代わりに、仮想空間で見本を量産する発想である。
ビジネスへの示唆
注目すべきは、ロボット導入の障壁が「機体の性能」から「現場ごとの教え込みの手間」へ移っている点である。この手法は、現場ごとの個別調整にかかる負担を減らせる可能性を示す。
具体的に恩恵を受けやすい業務は次のとおりである。
- 介護・医療施設:備品や日用品を棚から取り出して届ける補助業務。看護・介護部門の搬送工数や、職員の巡回負荷が指標となる
- 小売・倉庫:棚からの商品ピッキング。物流部門の作業時間やピッキング精度が指標となる
- オフィス・ホテル:備品や配膳物の取り出し。総務・施設管理部門の定型作業の人手が指標となる
読者自身の職場に引き寄せて考えたい。自部署で「決まった場所から決まった物を取って運ぶ」作業は何か。いま誰が、1日にどれだけの時間をその作業に割いているか。さらに、置き場所や扱う物が現場ごとに違うために、従来の自動化が見送られてきた業務はないか。こうした問いに該当する業務が多いほど、本技術の恩恵は大きくなる。
なお、成功率は6割台であり、人間の作業を丸ごと置き換える水準ではない。人が補助する前提での運用設計が現実的である。
現場での導入イメージ
仮に導入支援に入るなら、次の流れが考えられる。
- 棚卸し:どの取り出し・運搬作業に時間がかかり、人手が詰まっているかを可視化する。対象の置き場所と物の種類を洗い出す。目指す到達点は、ロボット化の候補業務が、頻度と負担の観点で優先順位づけされた状態である。
- 差し込み先の設計:新しい仕組みを増やさず、既存の在庫管理や作業指示の流れのどこにロボットの依頼を載せるかを決める。撮影は現場担当者がスマートフォンで行える範囲に収める。目指す到達点は、現場の担当者が特別な技能なしで撮影から依頼まで回せる状態である。
- 小さく試す(PoC):一つの部署、一つのエリアに絞り、数週間で試す。成功と失敗の内容、人が介入した場面を担当者の実感として確かめる。目指す到達点は、小さく安く始めて、効果と限界の見極めがついた状態である。
- 運用と横展開:失敗時の人の介入手順や、安全面の基準を整え、他部署や他拠点へ広げる。レイアウトや物の入れ替わりに応じて再撮影・再学習する周期も定める。目指す到達点は、現場が変わっても同じ手順で個別適応を繰り返せる状態である。
全体として目指すのは、「ロボットを導入するたびに専門家が現場へ張りつく」状態から、「現場の担当者が撮影するだけで、自分の職場に合うロボットが育つ」状態への移行である。
今後の展望
今回の評価は、単一の物体の拾い上げが中心である。人が行き交う環境での安全性や、扱える物体の幅、仮想空間と実機の差が大きい場面での頑健性は今後の課題である。ただし、仮想空間の成功率と実機の成功率が近い値を示した点は、シミュレーション中心の開発・検証手法の実用性を裏づける材料となる。現場適応の費用構造を変える技術として、動向を注視すべきである。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボット方策、物理時間を明示し遅延に強く
Chronos Policyは、観測の取得時刻と行動の実行時刻をロボット方策に明示的に与える手法である。センサーや推論の遅延が揺れる現場でも、動作の安定性を保てる可能性を示した。
物理を備えた3D資産をAIが自動生成
オックスフォード大などの研究チームが、重力下での安定性や衝突のない動きを備えた可動3D資産を自動生成する多エージェント方式「Artisan」と評価基準を公開した。見た目中心の3D生成が、実用段階へ進む。
外部映像から一人称視点を深度なしで生成
外部カメラの映像から作業者の一人称視点を生成する新手法LEGOが登場した。深度推定や点群化を省き、構造を担う変換器と細部を担う拡散モデルを分担させ、従来法を上回る精度を示した。