QuranicMMLU、選択式が生成AIの弱点を隠すと指摘
クルアーンのアラビア語に関する言語知識を測る評価基準「QuranicMMLU」が公開された。12システムの選択式正答率は平均84%だが、自由記述の品質は平均60%にとどまり、選択式評価が実力を過大に見せることが示された。
研究の概要
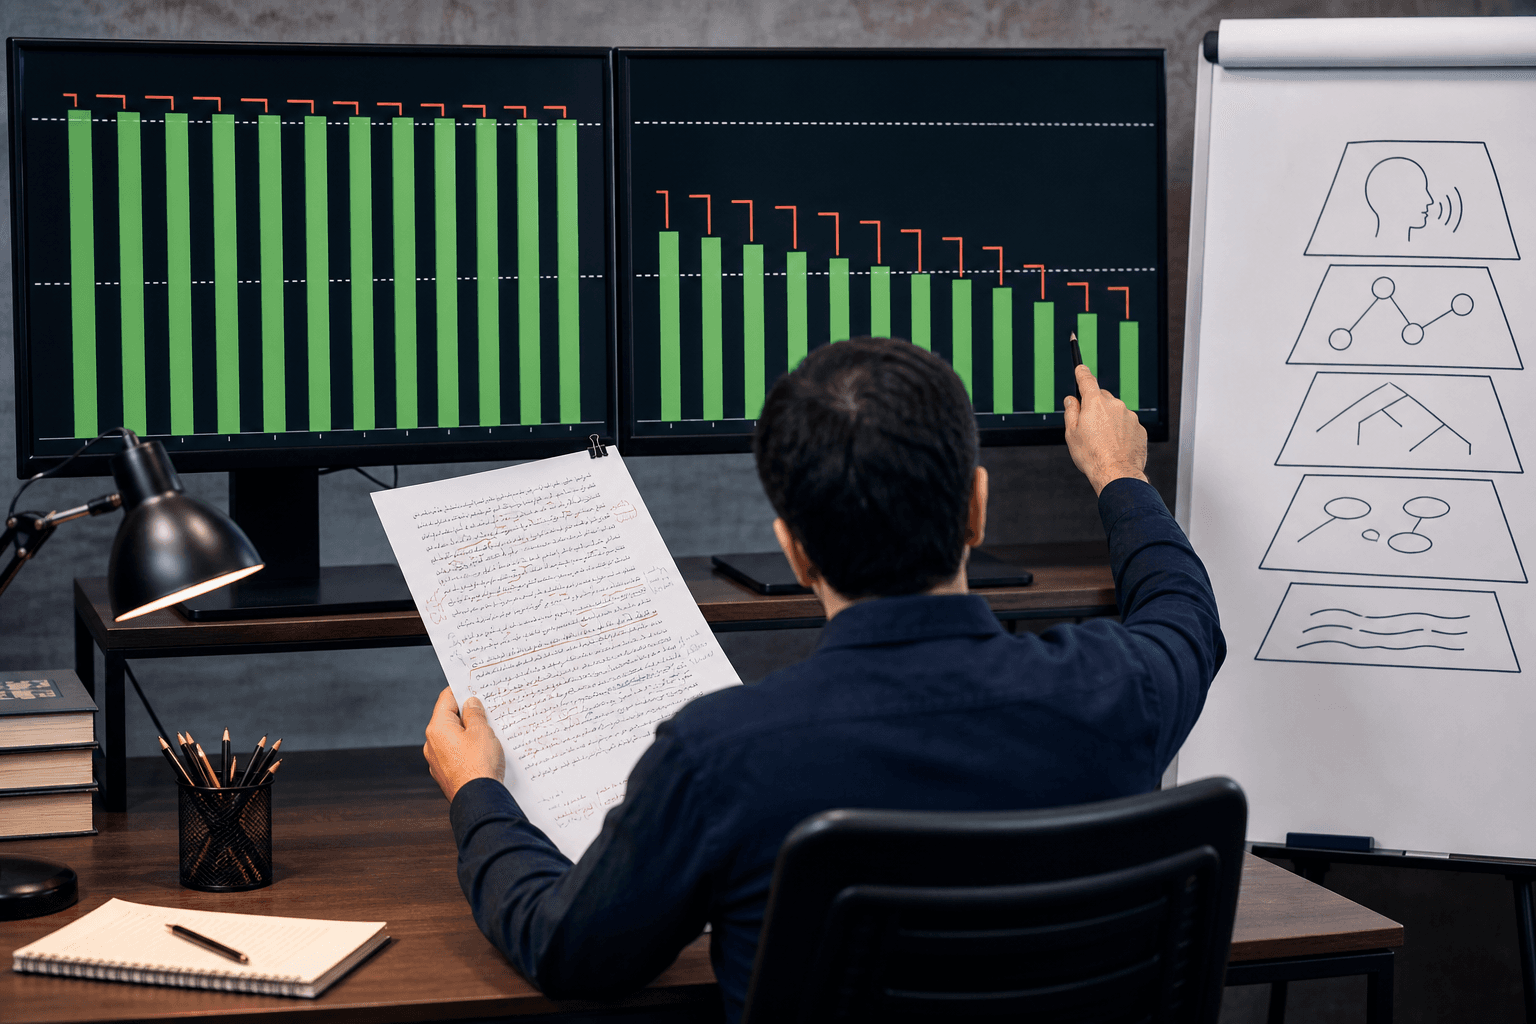
Ehsaneddin Asgari氏らの研究チームは、クルアーン(コーラン)のアラビア語に対する生成AIの理解度を測るベンチマーク「QuranicMMLU」を構築した。既存のクルアーン関連の評価は一般的な質問応答や意味検索が中心で、特定の言語能力を測ることや、認知的な難度・詩節の難度で層別化することができていなかったという。
分類体系は音韻、形態、統語、意味、語用の5本柱で構成され、朗誦規則のタジュウィードや語根・語型の形態論から、啓示の背景、章間の一貫性まで31の下位項目を含む。各項目でブルームの認知レベルと詩節のパープレキシティ(言語モデルにとっての予測しにくさ)に応じて問題を生成し、LLMを審査役として独立に回答・採点させたうえで、注釈を人手レビューに回した。最終的に980問を、自由記述と多肢選択の両形式で整備している。
12システムを評価した結果、イスラム分野に特化したモデルが首位となった。一方で全システムが、多肢選択の正答率(平均84%)より自由記述の回答品質(平均60%)で低い成績となった。両形式の順位の一致度はケンドールのτで0.73と高いものの、選択肢を取り除いて初めて表面化する失敗が、多肢選択では見えなくなると指摘している。
ビジネスへの示唆
対象はクルアーンに限られるが、評価設計の教訓は幅広い業界に及ぶ。最大の論点は、平均で24ポイントに達する形式間の乖離である。多肢選択の点数だけで生成AIの導入可否を判断すれば、顧客対応や教材作成といった実運用で求められる自由記述の品質を過大に見積もる恐れがある。
影響が大きいと考えられるのは、宗教・言語教育の分野である。アラビア語やイスラム教育のアプリを手がける教育サービス企業では、学習者への解説の正確性が信頼に直結する。中東や東南アジアで事業を展開する企業のカスタマーサポート部門や、宗教的配慮が求められるコンテンツを扱う出版・メディア企業でも、誤った説明はブランド毀損につながりかねない。影響を受け得る部署と指標は次のとおりである。
- 品質保証部門:自由記述回答の品質スコア、選択式との乖離幅
- カスタマーサポート部門:誤回答に起因する問い合わせ・苦情件数、人手エスカレーション率
- 教育・コンテンツ部門:解説の正確性、学習継続率
- 調達・IT部門:モデル選定に要するPoC期間と再選定コスト
また、専門特化モデルが首位となった点は、汎用モデルを一律に採用するのではなく、領域ごとに候補を比較する調達方針の妥当性を裏づける。もっとも、この結果はクルアーンという限定領域に基づくもので、他分野での優位性を保証するものではない。
今後の展望
本研究の手法は、分類体系を定め、認知レベルと難度で問題を層別化し、LLM審査と人手レビューを組み合わせるというものである。法務、医療、製造など、自社の専門知識で評価基準を作る際の設計図として転用できる可能性がある。
実務では、選択式と自由記述の両スコアを併記し、乖離が大きいモデルを本番投入前に再検証する運用が現実的である。順位の一致度が高い点は、簡便な選択式を一次選抜に、自由記述を最終判定に用いる二段階評価が成立し得ることを示唆する。
ただし980問という規模は限定的であり、LLMによる審査には偏りが入る余地も残る。人手レビューに要する工程コストと評価精度の兼ね合いが、企業が同様の枠組みを導入する際の焦点となろう。
関連トピック
同セクションの記事
LLMがLinux試験を自動採点、教育DXに新基軸
スペインの研究チームが大規模言語モデルによるLinux/bash試験の自動採点システムを評価し、専門家との一致率ICC=0.888を達成した。IT人材育成コストの削減と採点品質の標準化に向け、教育機関・企業研修部門への応用が期待される。
触覚グラフ自動生成、教育DXを変革
視覚障害学生向けの3Dプリント触覚統計グラフを250ミリ秒以内に自動生成するソフトウェア基盤が開発された。教育機関のインクルーシブ対応コストと制作工数を大幅に削減し、企業の障害者雇用・人材育成にも波及する可能性がある。
AI教育支援ツールが教員の授業設計を変革
米ジョージア工科大学の研究チームが、生成AIと教員の間に「精査可能なインターフェース」を介在させることで、授業設計の効率・有効性・意欲を同時に向上させる手法を実証した。EdTech産業と企業研修市場に広範な影響を与える可能性がある。
