粒子競合法でGCNのラベル誤りを補正
ファブリシオ・ブレーベ氏は、グラフ構造でラベルの誤りを学習前に補正する手法PCC+GCNを提案した。ノイズ下でGCNの平均精度を1.67ポイント改善し、頑健な既存手法より高速に動作する。不正検知などの実務でデータ品質対策に資する可能性がある。
研究の概要
グラフ畳み込みネットワーク(GCN)は、取引先や顧客のつながりといったネットワーク構造を持つデータから、各ノードの属性を予測する機械学習モデルである。一方、教師ラベルに誤りが含まれると、その影響がグラフを介して周辺ノードへ波及し、予測性能が低下しやすいという弱点を抱える。
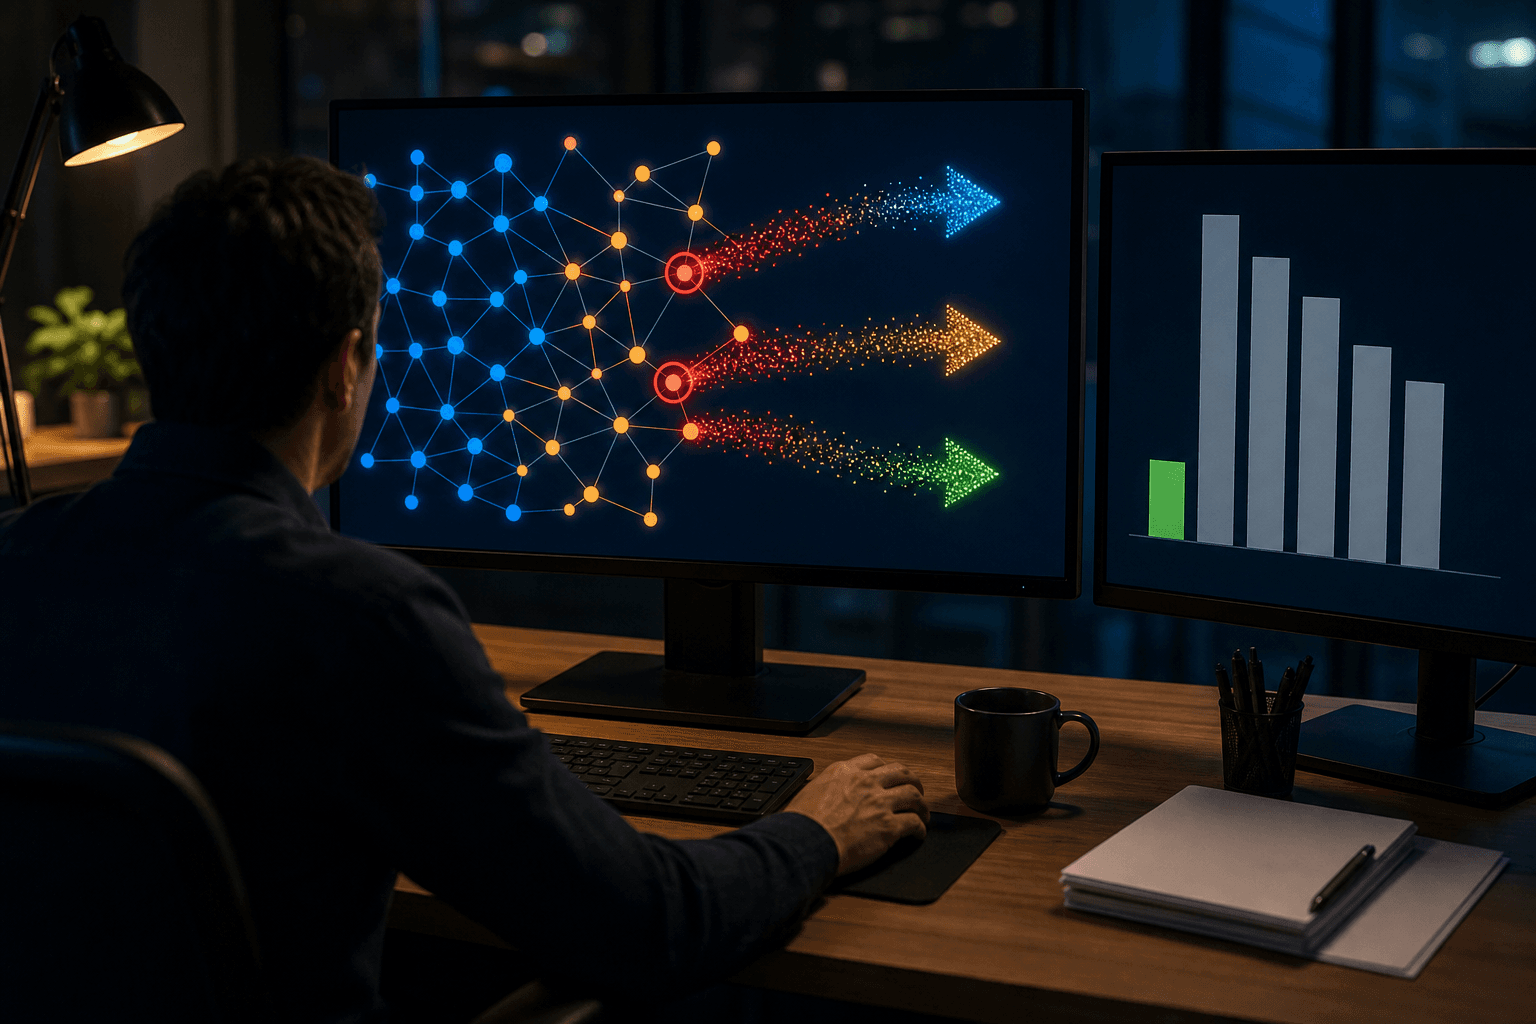
ブレーベ氏が提案したPCC+GCNは、GCNの学習に先立ってラベルを精査する二段階の枠組みである。前段の粒子競合協調(PCC)では、ラベル付きノードに対応する粒子がグラフ上で領域を奪い合い、その支配状況から疑わしいラベルを特定する。特定されたラベルは、保持、削除、付け替えのいずれかに振り分けられる。PCCが用いるグラフには特徴量に基づくk近傍の辺を加えることもできるが、GCN本体は元のグラフ構造と特徴量のまま学習する。
評価は、ラベルノイズ対策の標準ベンチマークであるNoisyGLの10種のグラフデータで実施された。ノイズには、一様、ペア、ランダムの従来型に加え、ノードの属性に依存して誤りが生じる事例依存型も用いられた。後者は実務上の誤りに近い性質を持つ。従来型ノイズでは、PCC+GCNが比較手法の中で最も高い平均精度と最良の平均順位を記録した。ノイズなしの条件と全ノイズ条件を通じ、素のGCNに対する平均改善幅は1.67ポイントである。事例依存ノイズでは最良の頑健手法と同等の水準を保ち、10データセット中8つで頑健手法の中で最短の実行時間を示した。
ビジネスへの示唆
実務データのラベル誤りは避けがたい。人手による付与の判断のばらつき、業務システムへの入力ミス、自動ラベリングの誤差などが主な原因である。関係性をグラフで扱う分野では誤りが周囲へ伝播するため影響が大きく、本手法は次のような領域で関心を集めるとみられる。
- 金融:不正取引や資金洗浄の検知。過去の調査結果に誤りが混在していても、リスク管理部門は検知精度の維持と、調査担当者の確認工数の抑制を両立しやすくなる。
- EC・マーケティング:顧客と商品のつながりに基づく離反予測や推薦。ラベルの質が改善すれば、解約率やコンバージョン率の向上につながる可能性がある。
- 製造・調達:取引先や部品の関係網を用いたリスク分類。調達部門での分類ミスの低減が期待される。
とりわけ注目されるのは計算効率である。本手法はGCNの学習前に挟む前処理であり、既存のGCN基盤を作り替えずに組み込める構成である。頑健性を高める他手法より実行時間が短い点は、データが頻繁に更新され再学習を繰り返す運用において、学習時間とクラウド計算コストの抑制に直結する。データ品質を担う部門にとっては、削除や付け替えの対象となったノードを、ラベル監査の優先順位付けに使う余地もある。
今後の展望
もっとも、留意点も残る。今回の検証は公開ベンチマーク上のものであり、平均1.67ポイントという改善幅が自社データで同程度得られる保証はない。事例依存ノイズでは最良の頑健手法と同等の水準にとどまり、精度面での優位が示されたわけではない。ラベルの付け替えが誤って行われた場合の影響も、導入時に確認すべき事項である。
導入を検討する企業には、まず不正検知や顧客分類など、ラベルに一定の誤りがあると分かっている既存のグラフ分析業務で、精度と処理時間を現行手法と比較する検証が求められる。AIの業務適用が広がるなか、ラベル誤りはモデル改良だけでなくデータ運用の課題でもある。ラベル品質そのものへの投資と、モデル側の頑健化を組み合わせる二段構えが、現実的な選択肢となろう。
関連トピック
同セクションの記事
Gricea、対話AI研究の再現を可能に
研究チームが、対話型AIの実験を共有可能な研究資産として構成・実行できるオープンサイエンス基盤「Gricea」を発表した。CUI 2026論文の93%で設定を再現し、96%で再現に必要な情報の欠落を確認した。
AI記憶の採否判定層、幻覚を約56%削減
LLMエージェントが参照する記憶の信頼性を判定する制御層MDLが提案された。矛盾する記憶下の幻覚率を一般場面で約56.04%削減し、1判定0.14ミリ秒と軽量である。
AIの安全ゲート認証、データ不足が壁と判明
AIが自信のない回答を控える選択的予測で、目標精度の認証を得られるかは有限の較正データに左右されることを、研究チームが計算可能な枠組みで示した。安全性・粒度・対応範囲の両立を事前に設計できる。