AI記憶の採否判定層、幻覚を約56%削減
LLMエージェントが参照する記憶の信頼性を判定する制御層MDLが提案された。矛盾する記憶下の幻覚率を一般場面で約56.04%削減し、1判定0.14ミリ秒と軽量である。
研究の概要
大規模言語モデル(LLM)の記憶機構は、検索の効率化に研究が集中してきた。検索で得た記憶を信頼してよいかという判断は、ほとんど検討されてこなかった。Yiming Zhang氏ら5人の研究チームは、この空白を埋める記憶判断層「Memory Decision Layer(MDL)」を、arXivで公開した論文で提案した。
問題の背景には、標準的な検索拡張生成(RAG)の性質がある。RAGは検索した記憶をそのまま生成に注入するため、記憶の中に矛盾する立場が混在すると幻覚を増幅する。論文によれば、記憶の注入の影響を受けやすいモデルでは、矛盾する記憶下でのRAGの幻覚率が、記憶を使わない基準設定より明確に高かった。記憶を足すことで、かえって精度が下がる逆転である。
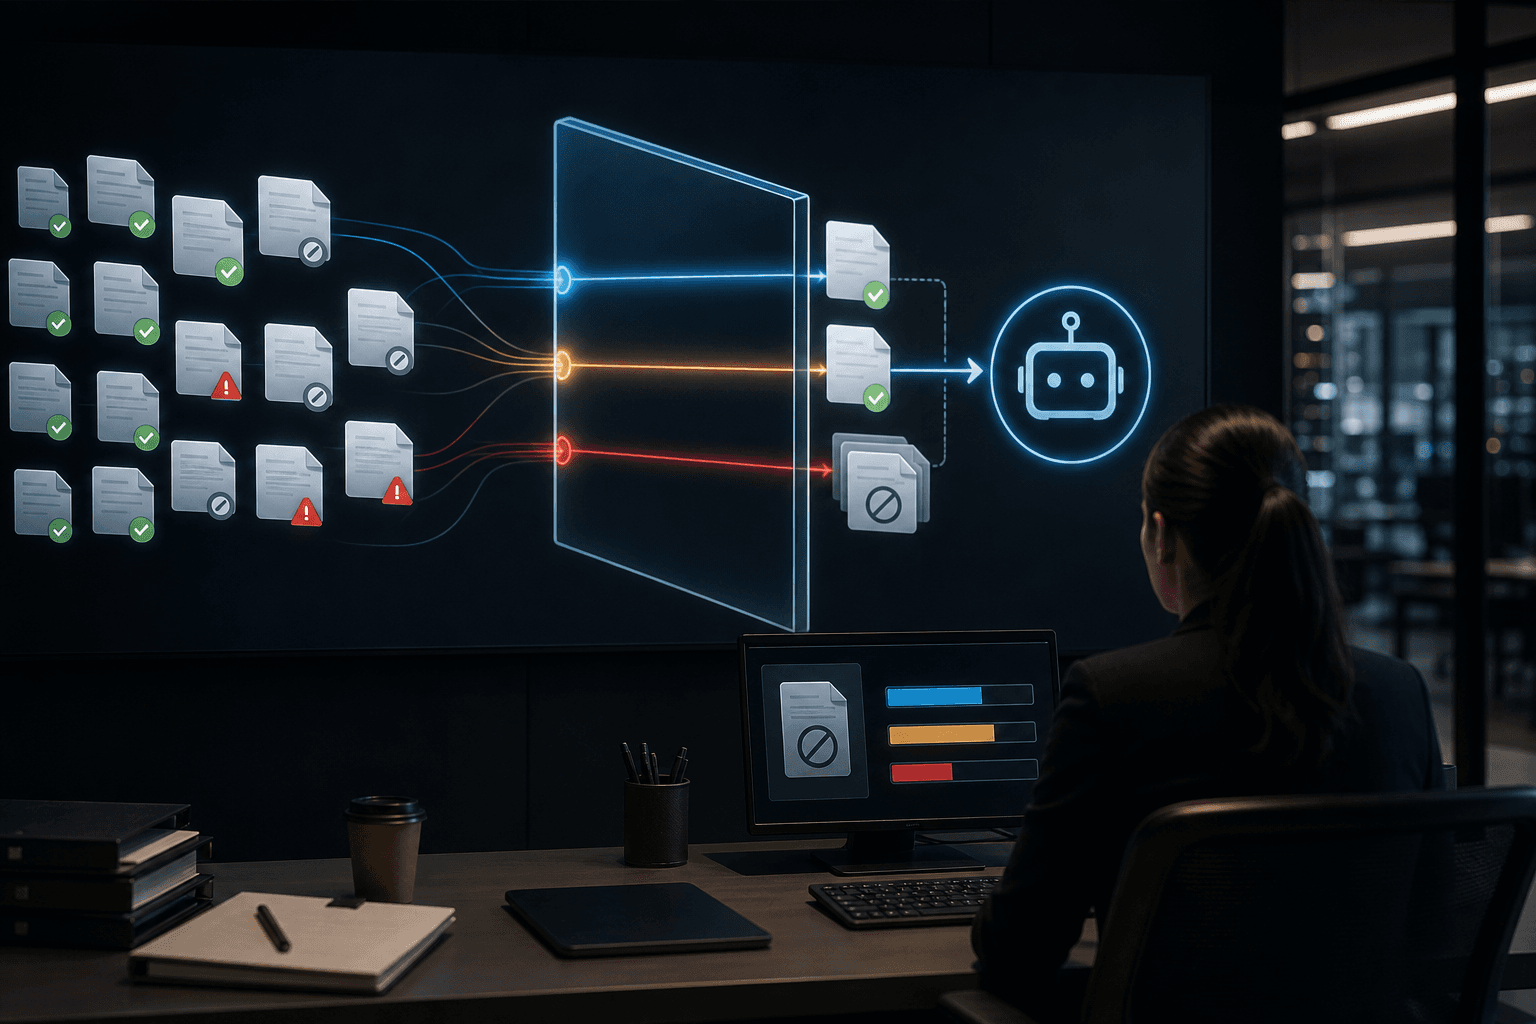
MDLは検索段階と生成段階の間に置く制御器で、学習パラメータを持たない。中核は、関連性、信頼性、タスクリスクの3信号を統合する符号化器である。QR分解に基づく直交部分空間への射影とメタ作業記憶信号を用い、検索された記憶の信頼度を解釈可能な表現に変換する。前頭前皮質の記憶信号機構に着想を得たという。さらに、確信度と一貫性を切り離して扱い、リスクの反転と明示的な棄権(回答保留)を導入した。
評価は主要なLLMと複数の公開データセットで行われた。矛盾する記憶下の幻覚率は、一般的な場面で約56.04%低下し、高リスクの場面ではゼロに近づいた。処理は幾何演算のみで、1回の判断に要する時間は約0.14ミリ秒である。直前の埋め込み検索の約50分の1、LLMに自己評価させる呼び出しと比べると4〜5桁短い。
ビジネスへの示唆
企業のAI活用で問題になるのは、社内文書や過去の対応履歴が必ずしも整合していない点である。改定前後の規程、担当者ごとに異なる回答、更新されないマニュアルが混在すれば、RAGは矛盾を抱えたまま回答を生成する。MDLは、回答の生成前に記憶の採否を判定し、疑わしければ回答を控える仕組みを、既存の検索基盤に挟み込む形で実現する。
適用が見込まれるのは、誤答のコストが大きい部門である。以下は論文が検証した範囲を超える推測を含むが、有力な候補となる。
- 金融・保険のコンプライアンス部門:規程や法令解釈の誤引用率、監査指摘件数
- 医療・製薬の情報提供部門:ガイドライン改定をまたぐ回答の誤り率
- 法務部門:契約条項や判例参照の誤り率、弁護士の確認工数
- カスタマーサポート:一次解決率、誤案内による再問い合わせ率、有人転送率
高リスク場面で幻覚がゼロに近づくという結果は、明示的な棄権と表裏一体である。棄権が増えれば回答率は下がり、有人対応への転送が増える可能性がある。誤答の削減と対応工数の増加のバランスを、企業は自社のKPIで管理する必要がある。要旨からは棄権の頻度が読み取れず、導入時に確認すべき項目となる。
運用面では、白箱である点が評価される。判断が幾何演算で完結するため、なぜその記憶を採用または棄却したかを信号ごとに説明できる。監査や説明責任が求められる金融・医療の現場では、ブラックボックスなLLMの自己評価に頼らずに済む利点となる。学習が不要なため、追加のデータ整備やモデル再学習の費用も抑えられる。
コスト面では、0.14ミリ秒の遅延は実質的に無視できる水準である。LLMの自己評価のように推論呼び出しを増やさないため、大量の問い合わせを処理するコールセンターでも、応答時間や1件当たりの推論費用を悪化させずに信頼性を高められる公算が大きい。
今後の展望
実用化に向けた課題は残る。評価は公開データセットで行われており、企業固有の業務文書や、更新履歴の複雑な社内ナレッジでの効果は未検証である。信頼性やタスクリスクの信号を業務に合わせて機能させるには、情報源の格付けや業務ごとのリスク区分を、企業側が整備する必要があると考えられる。また、効果は記憶の注入の影響を受けやすいモデルで顕著に現れるため、自社の利用モデルの感度を事前に測ることが望ましい。
エージェントが長期記憶を蓄積し、業務を自律的に進める利用が広がれば、記憶の採否を統制する層は、精度向上の部品にとどまらず、AIガバナンスの要件として位置づけられる可能性がある。検索の高速化競争に続き、記憶の信頼性をどう担保するかが、企業のAI基盤選定における次の評価軸となる。
関連トピック
同セクションの記事
Gricea、対話AI研究の再現を可能に
研究チームが、対話型AIの実験を共有可能な研究資産として構成・実行できるオープンサイエンス基盤「Gricea」を発表した。CUI 2026論文の93%で設定を再現し、96%で再現に必要な情報の欠落を確認した。
AIの安全ゲート認証、データ不足が壁と判明
AIが自信のない回答を控える選択的予測で、目標精度の認証を得られるかは有限の較正データに左右されることを、研究チームが計算可能な枠組みで示した。安全性・粒度・対応範囲の両立を事前に設計できる。
AI生成コードの検証、研究者は個人判断に頼る
研究者527件の自由記述の分析で、AIコーディング支援の利用が5種の作業に集中する一方、生成コードの検証は個人判断に委ねられ、自動テストや他者レビューは少ないことが分かった。