LLMの数学力、弱点は「発見」と判明
米大学などの研究チームが、LLMの数学的理解を4能力で診断する新指標を提案した。正答率に隠れた弱点は「発見」にあり、補強で推論精度が向上するため、業務AIの品質改善に直結する。
研究の概要
米国の研究チームは、大規模言語モデル(LLM)が数学の難問を解く際に、解法の構造を実際に理解しているのかを検証する研究を公表した。著者にはミラ・バンサル氏ら、AI分野で知られる研究者が名を連ねる。
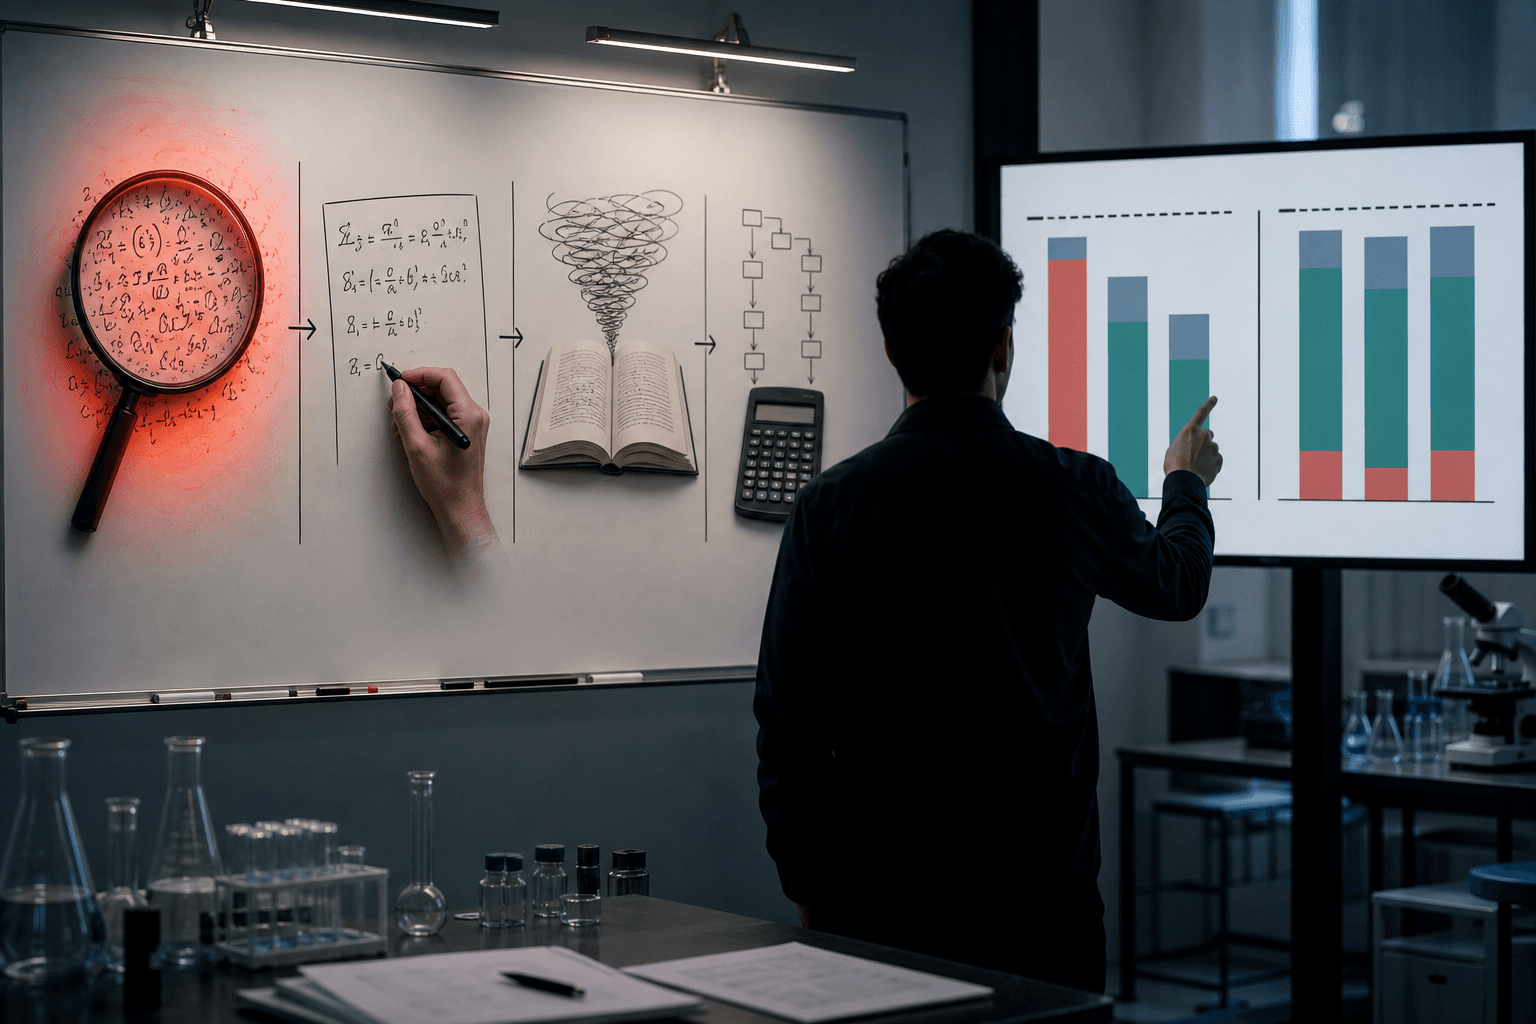
研究では、問題解決の土台となる「数学的プリミティブ」という概念を導入した。これは解法に必要な基本的な定理や操作の単位を指す。この概念に基づき、数学的推論を発見、生成、消化、実行の4次元で測定する新たなベンチマークを構築した。発見は解法の鍵となる要素を見いだす力、生成は必要な要素を作り出す力、消化は与えられた要素を理解する力、実行は手順を正確にたどる力である。
診断の結果、3点が明らかになった。第1に、正答率が同程度のモデルでも、4次元の能力配分は大きく異なる。第2に、適切なプリミティブを与えると、モデルが潜在的に持つ実行能力が大きく引き出される。第3に、数学的推論における最大の障壁は発見である。
さらに事後学習の分析では、発見の不足に起因する失敗は修復しやすいことが示された。この知見を踏まえ、研究チームはプリミティブを特権情報として与えた教師モデルの推論を、生徒モデルへ選択的に転移する自己蒸留の枠組みを提案した。複数のモデル規模と難度の高いベンチマークで、既存の手法を一貫して上回る改善が報告されている。
ビジネスへの示唆
最大の含意は、正答率という単一指標によるAI評価の限界である。同じ正答率でも失敗の原因が異なれば、必要な対策も異なる。この診断型の評価は、AIを業務に導入する企業の品質管理に応用できる。
影響が大きいと見られる分野と指標は次のとおりである。
- 金融:リスク計量、価格算定、監査支援における計算ミスの削減。誤り検出率や再計算工数が主なKPIとなる。
- 製造:設計計算、工程最適化、品質統計の自動化。設計レビューの手戻り率や不良率の低減が見込まれる。
- 教育:個別指導AIによる誤答の原因診断。学習者のつまずき位置の特定精度や学習定着率が指標となる。
- 保険・物流:数理モデルを用いた需要予測や配送計画の検証工数の削減。
AI導入を担う情報システム部門やデータサイエンス部門にとっては、モデル選定の基準が変わる可能性がある。従来は公開ベンチマークの総合得点で比較することが多かったが、今後は自社業務で必要な能力、たとえば手順の遂行か、着想の発見かを切り分けて評価する手法が求められる。
自己蒸留の枠組みも実務上の意義が大きい。教師側にのみ追加情報を与え、その推論を生徒モデルへ移すため、推論時には追加情報が不要で、小型モデルの精度を底上げできる。自社データで小型モデルを運用する企業は、推論コストや応答遅延を抑えつつ精度を高める選択肢を得る。クラウド利用料の抑制や、機密データを外部に出さないオンプレミス運用との相性も良い。
今後の展望
今後の焦点は、数学以外の領域への展開である。会計、法務、医療などの業務推論でも、問題の核心を見いだす発見の力が精度を左右する可能性がある。仮に同様の構造が確認されれば、業務別の診断指標と補強学習が新たな市場を形成するだろう。
ただし留意点もある。今回の成果は数学ベンチマークでの検証であり、実際の業務文書や曖昧な指示を含む環境で同じ効果が得られるかは未検証である。また、プリミティブの設計や付与には専門知識が要るため、導入コストの見極めが必要である。
企業にとっては、AIの誤りを一括りにせず、原因別に捉える視点が品質向上の出発点となる。モデルの提供事業者に対し、能力別の評価結果の開示を求める動きも、調達の場面で広がる可能性がある。
関連トピック
同セクションの記事
複数教師の蒸留、学習の落とし穴を解明
複数のRL教師の能力を1つの小型モデルへ統合する蒸留で、損失の平均化方式や数値精度が成果を左右することが判明した。AI開発の品質管理と計算コストに直結する知見である。
OmniSeek、音声映像を能動的に探索
長い音声付き映像から、必要な場面を自ら選んで見聞きする推論AI「OmniSeek」が登場した。映像と音声の両方を根拠とする推論を促し、監視や会議分析の精度向上に道を開く。
ループ型AI、推論精度向上と計算半減を両立
米研究チームが、ループ型Transformerの途中計算を活用し追加学習なしで推論精度を高める手法LoopCDを開発した。ループ数を半減しても同等以上の精度を保ち、演算量を最大48.2%削減した。