OmniSeek、音声映像を能動的に探索
長い音声付き映像から、必要な場面を自ら選んで見聞きする推論AI「OmniSeek」が登場した。映像と音声の両方を根拠とする推論を促し、監視や会議分析の精度向上に道を開く。
研究の概要
OmniSeekは、音声と映像を同時に扱う大規模言語モデル(Omni-LLM)を、複数ターンで推論する能動的なエージェントへ変える枠組みである。Haibo Wang氏、Lifu Huang氏、Mingze Xu氏らの研究チームが論文として公開した。
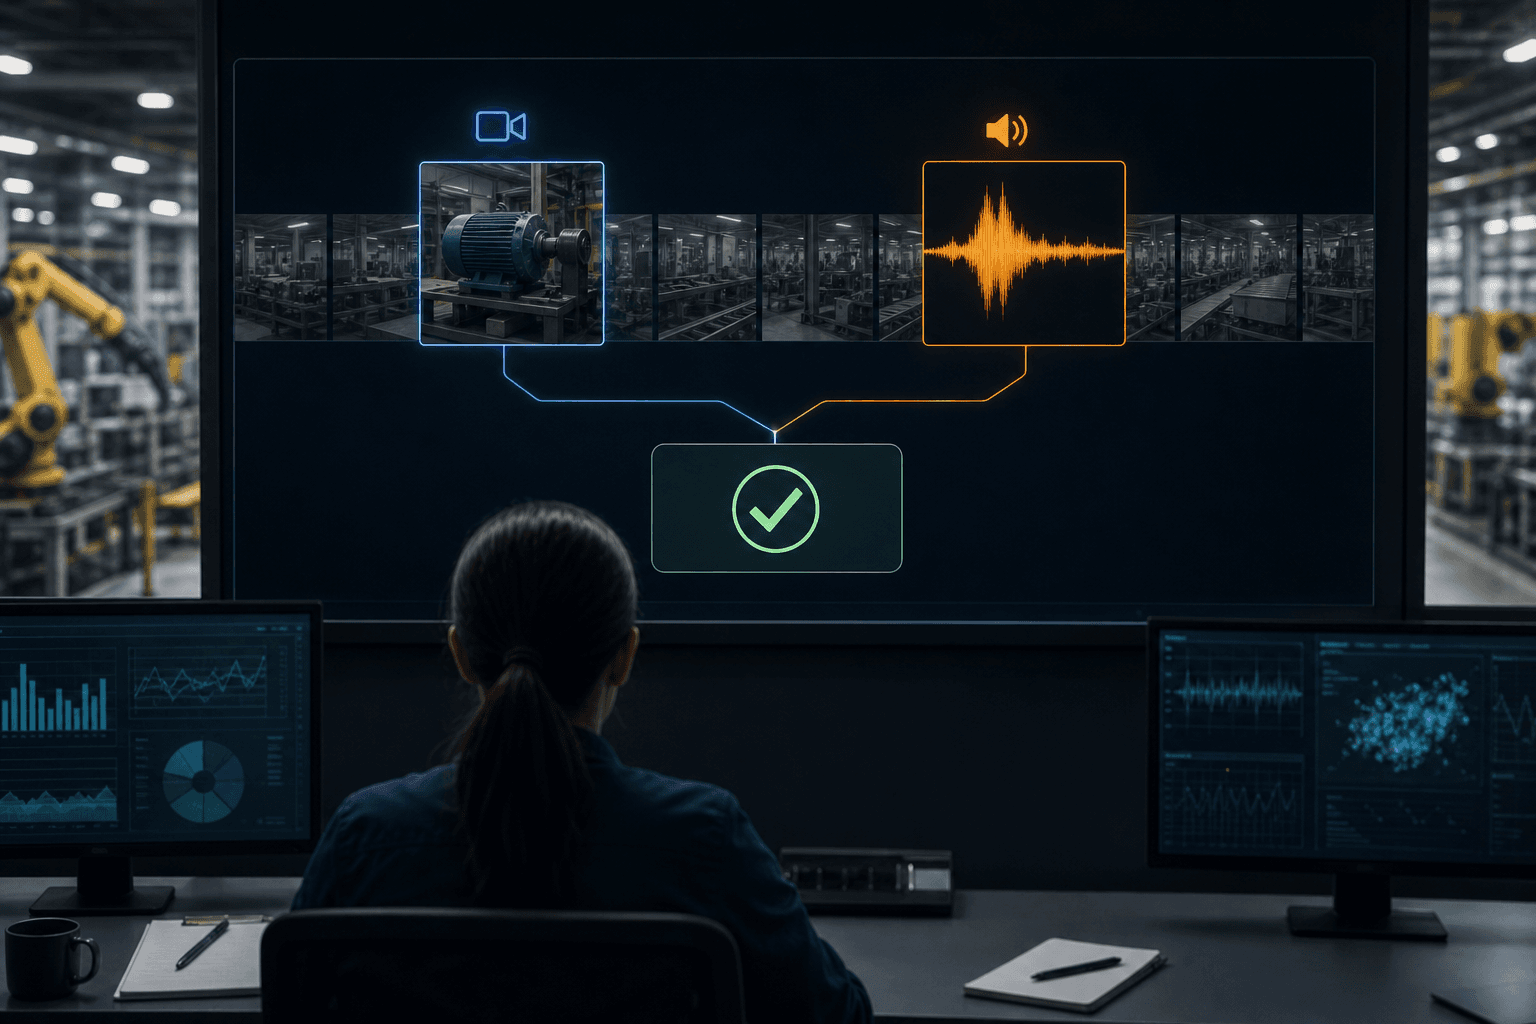
従来のモデルは、長い動画と音声を一度にまとめて入力し、1回の処理で答えを出していた。この方式では入力が長くなるほど、重要な場面が膨大な情報に埋もれやすい。OmniSeekは、証拠の取得そのものを推論の一部に組み込んだ。モデルは「見るのか、聞くのか」、さらに「どの時間帯を対象とするのか」を自ら判断し、必要な映像または音声の断片だけを取得して文脈に追加する。この手順を繰り返し、段階的に結論へ近づく。
学習は2段階で進める。まず、音声と映像の証拠を交互に挟んだ多段階の思考過程を合成するデータエンジンを構築し、約17万件の学習データ「OmniTraj-170K」を作成した。このデータで教師あり学習を行い、道具を繰り返し使う振る舞いを習得させる。次に、正誤を自動判定できる報酬を用いた2段階の強化学習で方策を最適化する。
さらに「Audio-Visual Necessity」と呼ぶ目的関数を導入した。正解にたどり着いた推論のうち、音声と映像の双方に依拠したものを高く評価する仕組みである。どちらか一方だけで答えを出す近道を抑える狙いがある。著者らは、幅広いベンチマークで適応的な証拠探索が身につき、音声映像の推論性能が一貫して向上したと報告している。
ビジネスへの示唆
最も恩恵が大きいのは、長時間の映像と音声を扱う業務である。
- コールセンター・営業部門:通話録音と画面録画を横断的に調べ、クレームの発端や成約の決め手となった発言を特定する。平均処理時間の短縮と品質評価の網羅率向上が見込める。
- 製造業の品質保証部門:稼働中の設備映像と異音を突き合わせ、不具合の兆候を遡って確認する。原因究明に要する時間や、設備停止時間の削減につながる。
- 金融・法務部門:会議録画や面談記録から、特定の発言とその場の資料提示を併せて確認する。コンプライアンス監査の工数削減や、証跡確認の精度向上に資する。
- 教育・人事部門:研修や授業の録画から、理解が滞った場面を抽出する。教材改善の周期短縮に利用できる。
経済的な利点は、計算資源の効率にある。全編を高密度で処理せず、必要な区間のみ取得するため、長尺データほど推論コストを抑えられる可能性がある。ただし、複数回の取得を重ねるため、応答遅延が増える面もある。1件あたりの処理コストと遅延の両面を、導入前に検証する必要がある。
音声と映像の双方を根拠とすることを促す設計も、実務上は重要である。映像だけ、あるいは文字起こしだけに頼った判断は、皮肉や声色といった情報を取りこぼしやすい。両モダリティの根拠を要求する方式は、判断の説明可能性を高め、監査対応の面でも有利に働くとみられる。
今後の展望
実用化に向けた課題は残る。学習データは合成された軌跡であり、実際の業務映像に見られる雑音や専門用語、画質のばらつきに対する頑健性は、個別に確かめる必要がある。録画データには個人情報が含まれるため、取得した断片の保管や権限管理といったガバナンス設計も欠かせない。
一方で、AIが必要な証拠を自ら探しにいく設計は、動画解析の標準的な考え方になる可能性がある。企業は、まず録画データが蓄積されている部門で、検索や要約といった限定的な用途から検証を始めるのが現実的である。精度、処理コスト、遅延を指標に効果を測定し、段階的に適用範囲を広げることが求められる。
関連トピック
同セクションの記事
複数教師の蒸留、学習の落とし穴を解明
複数のRL教師の能力を1つの小型モデルへ統合する蒸留で、損失の平均化方式や数値精度が成果を左右することが判明した。AI開発の品質管理と計算コストに直結する知見である。
ループ型AI、推論精度向上と計算半減を両立
米研究チームが、ループ型Transformerの途中計算を活用し追加学習なしで推論精度を高める手法LoopCDを開発した。ループ数を半減しても同等以上の精度を保ち、演算量を最大48.2%削減した。
DMAD、高速画像生成の蒸留を簡素化
中国・米国の研究チームが、拡散モデルを少ステップで動かす蒸留手法DMADを発表した。補助モデルを不要とし、1~4ステップで教師モデルを上回る品質を示し、生成コストの削減に道を開く。