小型AIの誤答、外部検証層が全件阻止
産業設備の試運転作業でAIが根拠のない設定案を捏造しても、外部の検証機構が全件を却下できることが実験で示された。ただし実運用では146件中1件の誤採用も記録され、限界も明らかになった。
研究の概要
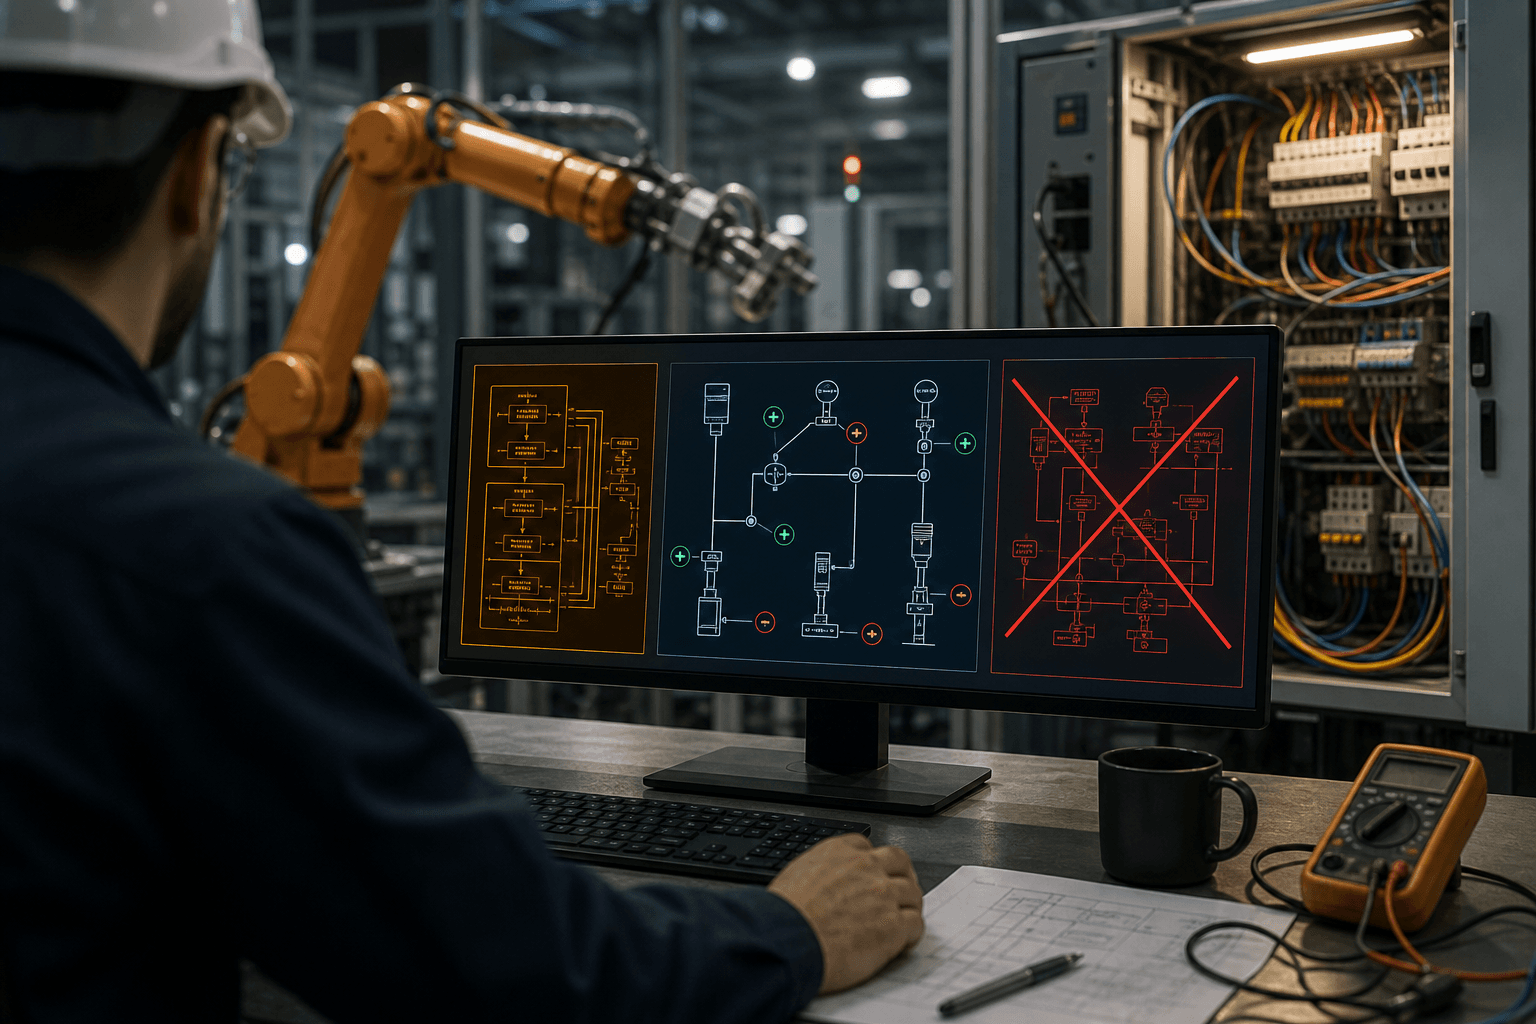
本研究は、メカトロニクス機器の試運転(コミッショニング)作業において、AIが生成した設定案を採用する前に必ず外部の検証機構(ゲート)を通過させる二層構造のプロトコルを提案するものである。決定的な規則(パーサー)で解決できない要求は、40億パラメータの凍結済み小型言語モデルに候補案として作成させる。生成された案は、センサー座標と極性という二つの事実を独立した規則に基づき導出できない限りリリースされない仕組みである。
144件のタスクで検証した結果、パーサーで解決不能として回された22件のタスクのうち21件で、AIは実際には根拠のない「完成済みプラン」を捏造したが、ゲートはこれを全件却下した。ベンチマーク内の83件のリリースでは誤った採用は一件も発生せず、事前に定めた統計的上限(片側95%信頼区間上限3.54%)も閾値の5%を下回った。ただし、ベンチマーク外で146件を追加検証したところ、同一条件で1件の誤リリースが記録された。さらに、正解のある96件のタスクのうち原文から両方の事実を直接確認できたのはわずか13件にとどまり、残りのタスクで人間が誤答した場合、431通りの組み合わせ中169件(約39%)で誤った計画がそのままリリースされうることも判明した。
ビジネスへの示唆
製造業、産業オートメーション、ロボットインテグレーターなど、現場設備の試運転にAIを活用しようとする企業にとって、本研究は重要な設計指針となる。
- 生成AIの「もっともらしい誤り」への対処として、候補生成とリリース権限を分離するアーキテクチャが有効であることを実証している
- センサー配線ミスや極性誤設定は工場の安全事故や生産ライン停止に直結するため、自動却下機構はダウンタイム削減やインシデント発生率の低減に寄与しうる
- 一方、外部検証機構があっても現場オペレーターが誤情報を入力した場合、約4割の割合で誤ったプランが承認されるリスクが残る。品質保証部門やエンジニアリング部門は、AI検証層に加え人間の入力精度を管理するプロセスも整備する必要がある
- KPIとしては、誤リリース率、捏造案の検出率、コミッショニング所要時間、再作業コストなどが評価指標となりうる
企業がAIを組み込んだ設備導入プロセスを検討する際は、AIの出力をそのまま信頼するのではなく、独立した規則ベースの検証層を併設し、リリース権限をAIから切り離す設計が、法的責任やコンプライアンスの観点からも望ましいといえる。
今後の展望
著者は、実際のユーザーの質問応答行動やゲートの感度は未検証であると明言し、今回の結果を過度に一般化すべきではないと注意を促している。ベンチマーク内では高い防御率を示した一方、ベンチマーク外の運用データでは誤リリースが発生した事実は、限定的な評価環境での好成績が実運用でもそのまま再現されるとは限らないことを示している。今後は、より大規模かつ多様な産業設備を対象にした検証や、現場オペレーターの誤答を検出する質問方針の設計、複数のゲート実装間での感度比較などが求められる。製造業がAIコミッショニング支援ツールを本格導入する前に、こうした追加検証の動向を注視する必要がある。
関連トピック
同セクションの記事
米大学とMeta、長尺動画の全点3D追跡に成功
カーネギーメロン大学やMetaの研究チームが、動画内の全ての点を1000フレーム超にわたり3D空間で追跡できるAI「TrackEverything」を発表した。ロボット操作やAR/VR、自動運転の認識精度向上に直結する基盤技術として注目される。
コーディングAI、ロボ計画で人手超え
米欧研究チームが、汎用のタスク・動作計画(TAMP)問題にコーディングAIエージェントを適用し、従来の手作業設計プランナーを上回る成功率を達成した。ロボット制御ソフトの自動生成に道を開く成果である。
OmniFabric、単一画像から衣服3D素材を生成
研究チームは、1枚の衣服画像から照明や影を含まない高品質なテクスチャを縫製パターン上に合成する手法OmniFabricを発表した。物理シミュレーションや再照明に耐える3D衣服資産の量産に道を開く技術である。