新AI手法が強化学習の試行回数を大幅削減
米研究チームが開発した「UBP2」は、AIへの人間のフィードバック回数を抑えつつ高精度な報酬学習を実現する手法で、製造・物流・ロボティクス分野における自動化コストの大幅削減が期待される。
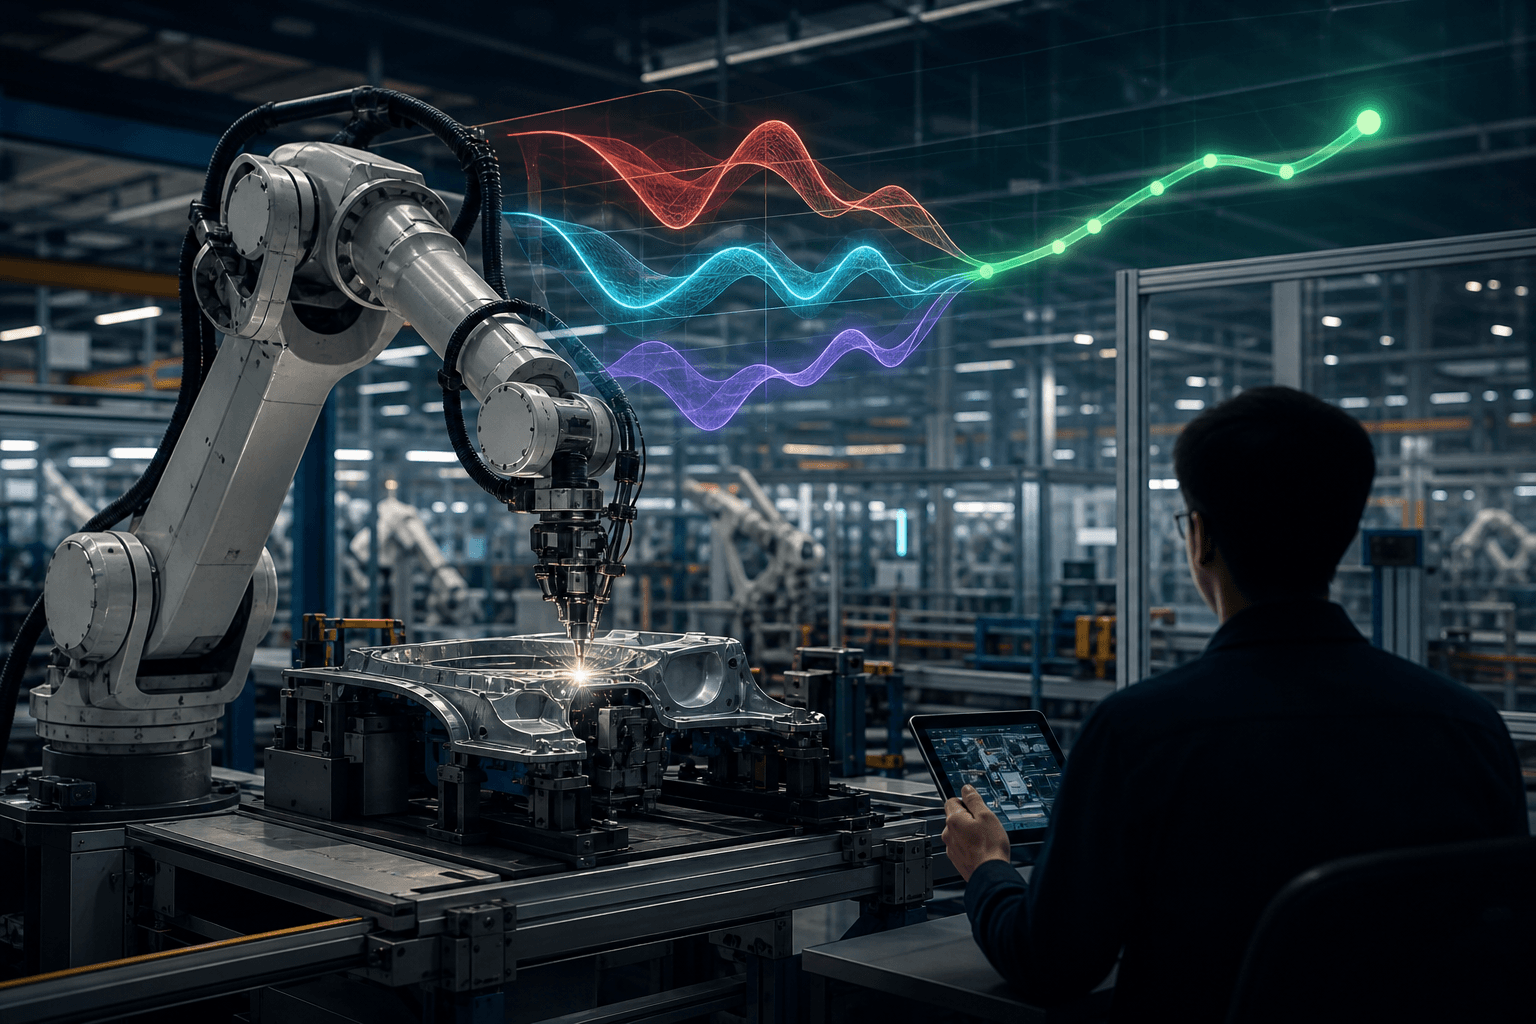
米国の研究チームは、強化学習における人間フィードバックの非効率性を克服する新手法「UBP2(Uncertainty-Balanced Preference Planning)」を発表した。従来手法と比較してサンプル効率を大幅に改善し、ロボット操作の標準ベンチマーク「Meta-World」において既存手法を上回る性能を示した。
強化学習とは、AIエージェントが試行錯誤を繰り返しながら最適な行動を学習する機械学習の一手法である。近年、報酬関数を人間が設計する代わりに、人間がAIの行動ペアを比較・評価することで学習させる「選好ベース強化学習」が注目されている。しかし既存手法は学習初期においてデータ収集が非効率であり、人間の評価者が膨大な回数のフィードバックを提供しなければならないという課題があった。
UBP2はこの問題に対し、報酬・ダイナミクス・価値関数という三つのモデルそれぞれの「不確実性」を統一的に評価し、探索と活用のバランスを自動的に最適化する仕組みを導入した。複数のモデルアンサンブルを用いて候補軌跡をスコアリングし、情報獲得と期待報酬を同時に最大化することで、少ないフィードバック回数でも高精度な行動方針を獲得できる。理論面では、有限・無限ホライズンの双方において「劣線形後悔」が保証されており、学習効率の数学的裏付けも示されている。
ビジネスへの影響は製造業において特に顕著である。産業用ロボットの動作設定には従来、熟練エンジニアが数週間をかけて評価データを収集する必要があった。UBP2の適用により、生産ライン部門では評価工数の削減とロボット立ち上げ期間の短縮が見込まれ、設備投資回収期間(ROI)の改善に直結する。自動車・電機メーカーの製造現場では、多品種少量生産への対応力を示すKPIである段取り替え時間の削減にも応用できる。
物流・倉庫自動化の領域でも活用可能性は高い。ピッキングロボットの行動最適化において、人間オペレーターによる評価回数が削減されれば、オペレーション部門の人的負荷が低下し、ピッキング精度や処理スループットといったKPIの向上が加速する。EC市場の拡大を背景に物流コスト削減を急ぐ小売・流通企業にとって、導入障壁の低下は即座に競争優位につながる。
ヘルスケア・リハビリテーション分野でも応用研究が期待される。手術支援ロボットや介護補助機器の動作学習においては、医療専門家による評価データが限られており、サンプル効率の向上は開発コストと安全検証期間の双方に影響を与える。医療機器メーカーの研究開発部門は、本手法を活用することで承認取得までのリードタイム短縮を図れる可能性がある。
課題も残る。現状の実証実験はシミュレーション環境に限定されており、実世界のロボットや産業設備への適用には追加検証が必要である。また、アンサンブルモデルの運用には相応の計算資源が求められるため、エッジ環境での展開にはハードウェアコストとの兼ね合いを慎重に評価する必要がある。研究チームは実環境への適用拡張を次の研究目標として挙げており、産業界との連携が今後の普及を左右するとみられる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
量子回路、課題の周波数構造を学習に組み込む
独自の「スペクトルクエリ」を量子回路に与えると、少ないデータでも学習が進むことを研究チームが示した。波形データの判定業務で、取得条件を設計に生かす発想として注目される。
ロボットの目標認識を明示化、探索成功率が向上
VLM由来のナビゲーション方針は、探索はできても目標を見落とす点が主な失敗原因と判明した。目標位置を明示的に捉える手法が6つの試験で最高水準となり、現場ロボットの実用性を左右する知見である。
Dense4D、人の動きを画素単位で追跡する
単眼のRGB画像から、服や髪を含む人体表面の同一点を3次元で追う新モデルDense4Dが登場した。体型テンプレートなしで高い追跡精度を示し、映像制作や動作評価の工程を変える可能性がある。