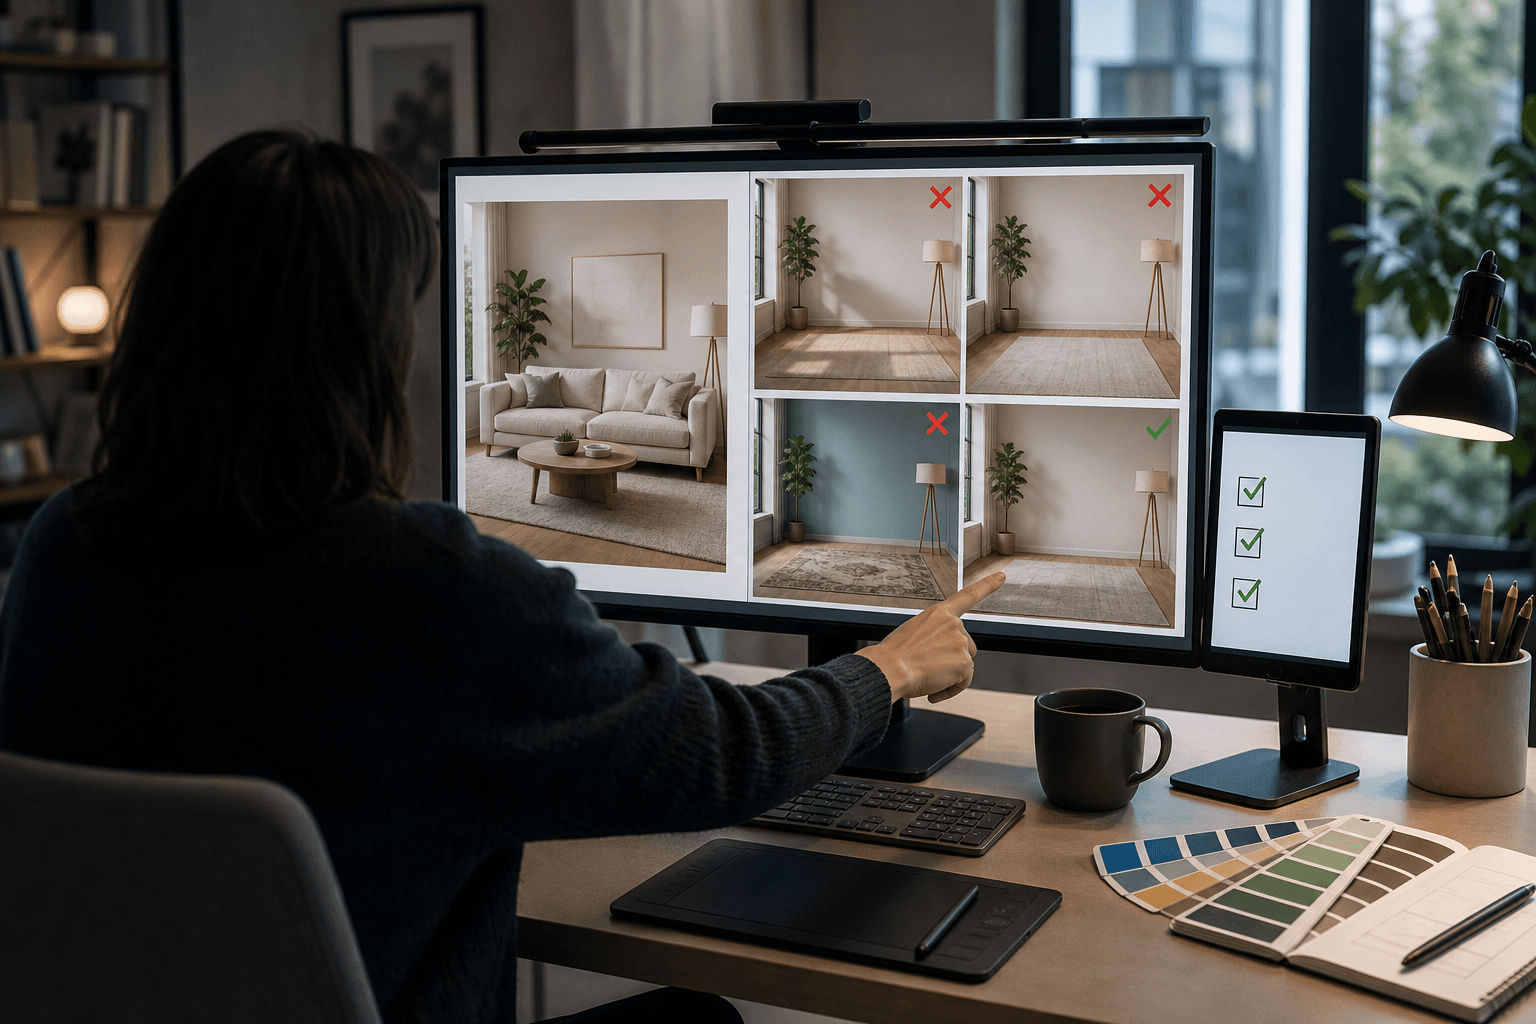
画像生成AI、逆流を抑え指示への忠実度向上
画像生成AIが途中経過の誤りを自らの文章理解に反映し、ずれを固定化する現象が判明した。この逆流を抑える新手法SFGは、追加コストを抑えつつ指示への忠実度を高める。
研究の概要
スタンフォード大学のヤン氏、ヤン・レヴィ氏らの研究チームは、最新の画像生成モデルが抱える構造的な弱点を突き止め、その対策手法を発表した。対象は、画像と文章を一つの注意機構で同時に処理する「マルチモーダル拡散トランスフォーマー(MMDiT)」である。FLUXやStable Diffusion 3.5といった主力モデルがこの構造を採用している。
MMDiTでは、生成途中の画像が文章側の内部表現を更新し、更新された表現が次の画像更新を導く。研究チームが問うたのは、この画像から文章への流れ(I2T フィードバック)が、プロンプトからのずれを修正するのか、それとも温存するのかという点である。
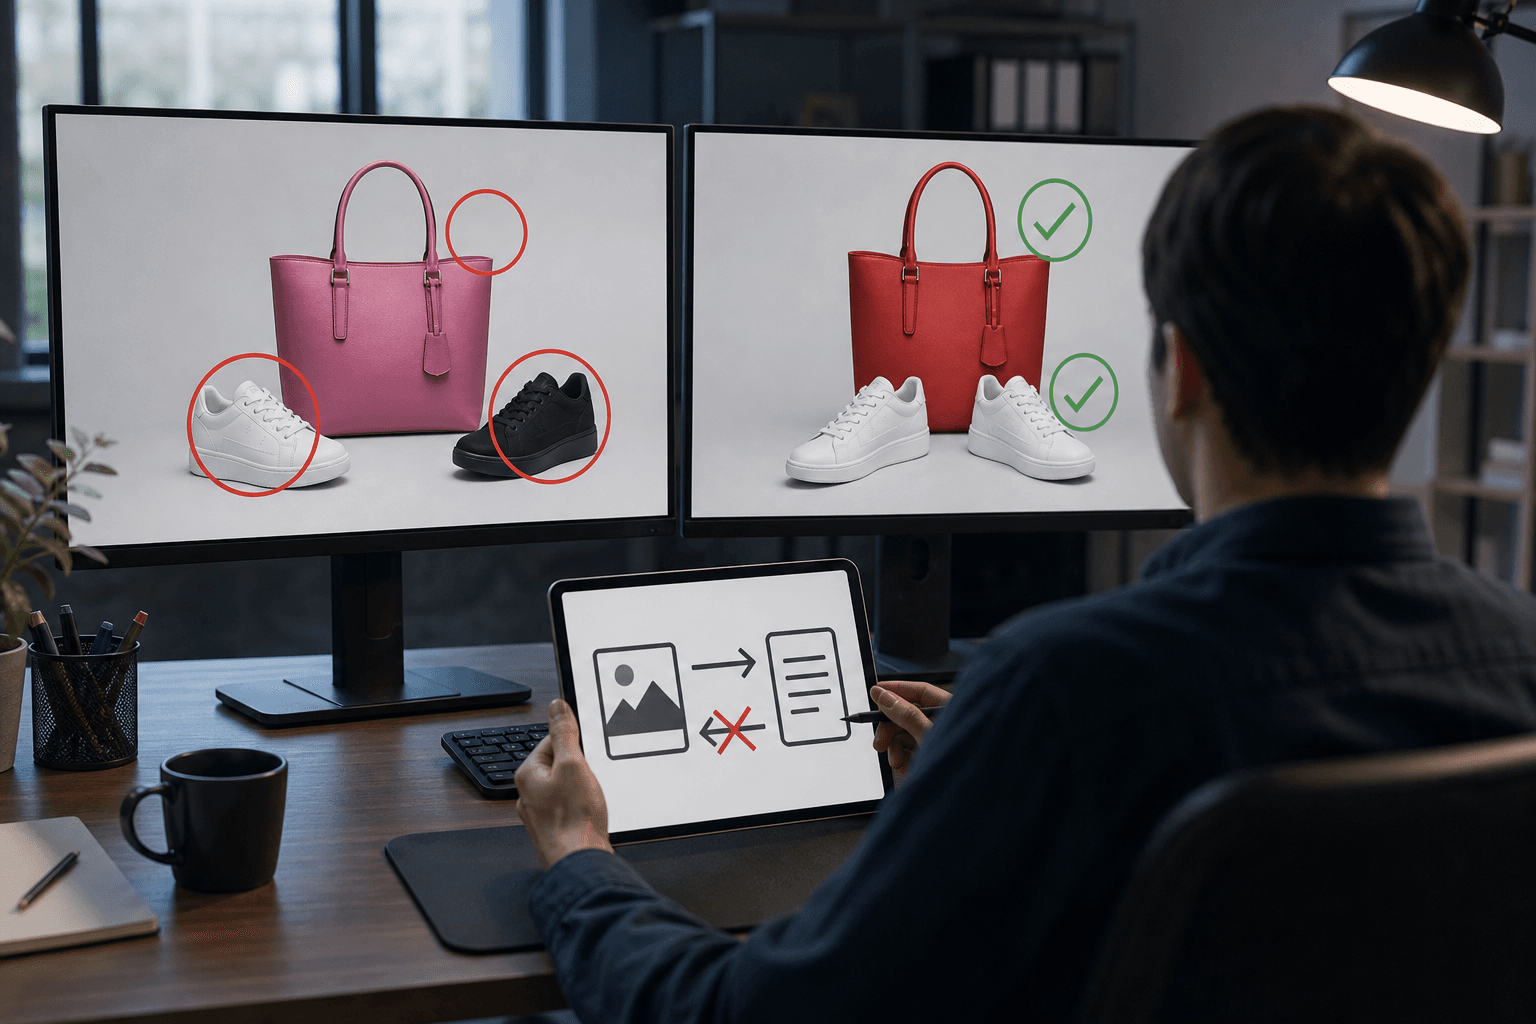
分析の結果、I2Tフィードバックは、生成途中の画像にすでに現れている物体や属性を、誤りも含めて保持する傾向があると分かった。I2Tのメッセージを別の生成過程から移植する実験では、失敗例を救うことも、成功例を壊すこともできた。同じ強さで介入した場合、I2Tの影響を抑えると生成品質が上がり、逆方向の制御では下がった。
しくみをやさしく
人間の作業に例えれば、発注書を読みながら試作品を作る担当者が、試作品の出来を見て発注書の解釈を書き換えてしまう状況に近い。試作品が誤っていれば、発注書の解釈も誤った方向に引きずられ、ずれが修正されなくなる。
提案手法のセマンティック・フィードバック・ガイダンス(SFG)は、この引きずりを弱める。具体的には、I2Tフィードバックを強め、文章から画像への条件付けを弱めた補助的な経路を用意する。本来の出力を、この補助経路から遠ざける方向へ誘導する。既存のCFG(分類器なしガイダンス)が「条件なしの出力から遠ざける」のに対し、SFGは「逆流を強めた出力から遠ざける」ものである。
さらに、モデル内部で直接I2Tを抑え、文章から画像への条件付けを強める軽量版iSFGも示された。こちらは追加のモデル評価を必要としない。時間方向の分析からは、生成初期の最初の20%のステップでSFGを働かせれば十分と分かり、CFGを使わない基本構成に対し計算量は約1.2倍にとどまる。
ビジネスへの示唆
実験は3種の画像生成基盤で行われた。FLUXではCFGにSFGを加えるとGenEvalが0.6661から0.7479に上昇した。SD3.5Mでは、iSFGがCFG比でHPSv2.1を1.33ポイント押し上げ、追加の計算は不要であった。動画生成(テキストから動画、画像から動画)でもVBenchの得点が改善している。
恩恵を受けるのは、生成画像を日常的に業務で使う部門である。たとえばEC事業のマーチャンダイジング部門では、商品バナーを「赤いバッグと白い靴」のように指定しても、色や個数が崩れて作り直す場面が多い。広告・宣伝部門のクリエイティブ制作、ゲームや映像の企画部門のコンセプトアート作成も同様である。自部署で、指示と異なる画像を選別し、プロンプトを書き直す作業に、誰がどれだけ時間を割いているかを確認したい。
動くとみられる指標は次のとおりである。
- 採用率(生成画像のうち実際に使える割合)
- 修正・再生成の回数と制作リードタイム
- 外注デザイナーへの修正依頼件数
なお、自社で画像生成モデルを運用する企業にとっては、推論コストをほぼ増やさずに品質を上げられる点が大きい。API経由の利用が中心の企業は、ベンダーの対応待ちとなる。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:生成画像の作り直しが多い業務を洗い出す。指示との不一致(色、数、位置関係の誤り)がどの工程で発生し、誰が手直ししているかを可視化する。目指す到達点は、効果を測るべき業務と現状の手戻りの実態が共有されている状態である。
-
差し込み先の設計:新しいツールを増やさず、すでに使っているFLUXやStable Diffusion系の生成環境に、公開コードを組み込む形を優先する。まずは追加計算のないiSFGから検討する。目指す到達点は、現行の制作フローを変えずに生成の裏側だけが差し替わる状態である。
-
小さく試す(PoC):一部署、数週間の範囲で、同じプロンプトを従来設定とSFG設定で生成し、担当者が見比べる。指示どおりかどうかの実感を基準に評価する。目指す到達点は、現場が「作り直しが減った」と判断できる根拠が得られている状態である。
-
運用と横展開:効果の出やすいプロンプトの型と、適用する生成ステップの範囲を社内基準として整え、他部署や動画生成へ広げる。目指す到達点は、品質基準が属人化せず、継続的に改善できる状態である。
全体として目指すのは、画像生成の「当たり外れ」を減らし、修正に費やす人手を企画や検証へ振り向けられる制作体制である。
今後の展望
本研究は、生成モデル内部の情報の流れに着目し、再学習なしで品質を上げる方向性を示した。モデルを作り直さずに推論時の制御で改善できるため、既存資産を活かしたい企業には現実的な選択肢となる。ただし、効果は評価指標上の改善であり、自社の商材やブランド表現で同様に働くかは検証が必要である。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
生成AI再撮影の破綻を撮影現場で事前に可視化
撮影後にカメラ動作を変える生成AI再撮影では、未撮影部分の捏造が撤収後に発覚する課題がある。新手法は現場で破綻リスクを即時に可視化し、手戻りの抑制を目指す。
静止3D空間を無限ループ動画化するAI登場
台湾の研究チームが、静止した3D空間に多様な動きを与え、どの視点からも途切れず循環させる手法OuroWorldを発表した。3D空間の「動く資産」化を低コストで進める技術として注目される。
画像編集AI、自作画像で自己改善する新手法
画像編集AIが人手の正解画像も外部の採点モデルも使わず、自らの生成物だけで性能を高める手法Rubric-CEPRが登場した。教師データ作成の負担を軽くできる可能性がある。