GMM推定に新手法、EMより頑健と実証
仏研究チームが成分数未知のガウス混合モデルを安定推定する新アルゴリズムを開発。従来のEMアルゴリズムより過大指定に強く、クラスタリング業務の試行錯誤コスト削減が期待される。
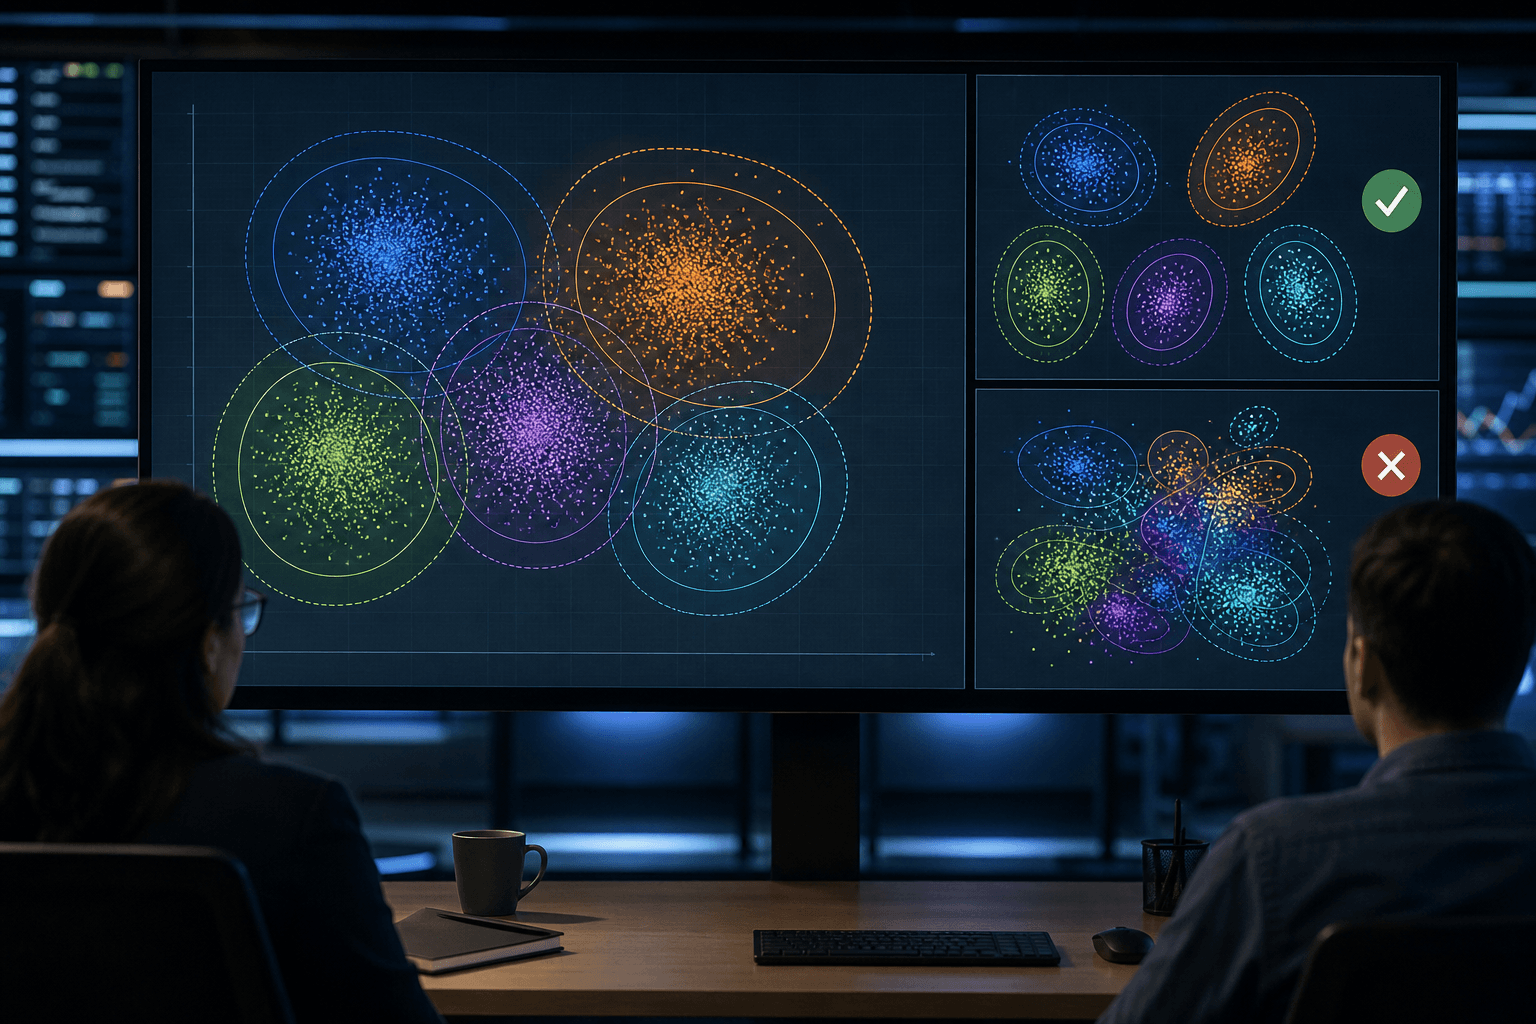
フランスの研究チームが、ガウス混合モデル(GMM)の成分数と分散が未知の場合でも安定して推定できる新アルゴリズムを開発した。従来主流のEMアルゴリズムに比べ、想定する成分数を実際より多く設定した場合でも精度が崩れにくいことを数値実験で示した。
研究の概要
GMMはデータが複数の正規分布の混合から生成されているとみなし、各集団の平均・分散・混合比率を推定する統計モデルである。従来のEMアルゴリズムは局所解に陥りやすく、あらかじめ成分数を正確に指定する必要があるという実務上の制約を抱えていた。
研究チームは、測度空間における疎な解を導く凸最適化手法「Beurling-LASSO(BLASSO)」と粒子ベースの勾配降下法を融合させ、さらに正規分布が持つ曲がった構造「フィッシャー・ラオ幾何」を考慮したリーマン勾配降下法を組み合わせた。理論面では、解が一定の分離条件を満たす場合に指数的な局所収束が保証されることを証明している。数値実験では、成分数を過大に指定してもEMより精度劣化が小さいこと、クラスタ間の分離度が推定精度に与える影響も定量的に検証された。
ビジネスへの示唆
GMMは顧客セグメンテーション、異常検知、品質管理など幅広い業務で使われる基盤技術であり、成分数の事前指定が不要になる利点は実務インパクトが大きい。
- マーケティング部門: 購買データから顧客層を自動抽出する際、想定顧客層数を厳密に決めずに分析でき、セグメント設計の試行回数を削減できる可能性がある。
- 製造業の品質管理部門: センサーデータの異常検知で不良モードの種類数が未知でも安定したクラスタリングが期待でき、歩留まり改善のリードタイム短縮に寄与する。
- 金融機関のリスク管理部門: 取引データの異常パターン検出や顧客リスク層の分類において、モデル再構築の頻度を抑えられる可能性がある。
いずれの用途でも、モデル選択(成分数決定)にかかる分析者の試行錯誤コストを削減し、分析サイクルタイムというKPIの改善につながる点が共通の利点である。
今後の展望
現時点では研究段階であり、実装の計算コストや大規模データへの適用可能性については検証が続く見込みである。論文は実装上の工夫にも触れており、オープンソース化が進めば統計解析基盤やBIツールへの組み込みが加速する可能性がある。企業側は既存のクラスタリング基盤の置き換えを急ぐ前に、まずは自社データでの再現実験を通じた効果検証を進めるべきだろう。
同セクションの記事
WanPEが動画生成の脚本精度を向上
研究チームが、動画生成AIの指示文を映画監督レベルの絵コンテへ自動変換する3970億パラメータのモデル「WanPE」を開発した。30秒動画で人間評価が50.86ポイント向上し、広告・映像制作業務の効率化に直結する。
欠損に強い感情分析手法SemMSAが登場
研究チームは、映像・音声・言語の一部が欠けても人の感情を推定できる手法SemMSAを提案した。SIMS、MOSI、MOSEIの3ベンチマークで最高水準の性能を示し、顧客対応や市場調査での実用化が焦点となる。
新手法HARMONY、1枚の写真から室内3D生成
Shufan Sun氏らの研究チームは、室内の1枚の画像から物体の位置関係まで整合した3Dシーンを復元する枠組み「HARMONY」を発表した。不動産や小売などで3D化の工程を簡素化する可能性がある。