反発型自己注意、カオスと局所化の相を解明
研究チームは、値写像を負にした最小のトランスフォーマーで、カオスや注意の凝縮が生じる条件を理論的に整理した。疎な注意が動的挙動を持続させうる点は、AIの安定運用を考える上で示唆に富む。
研究の概要
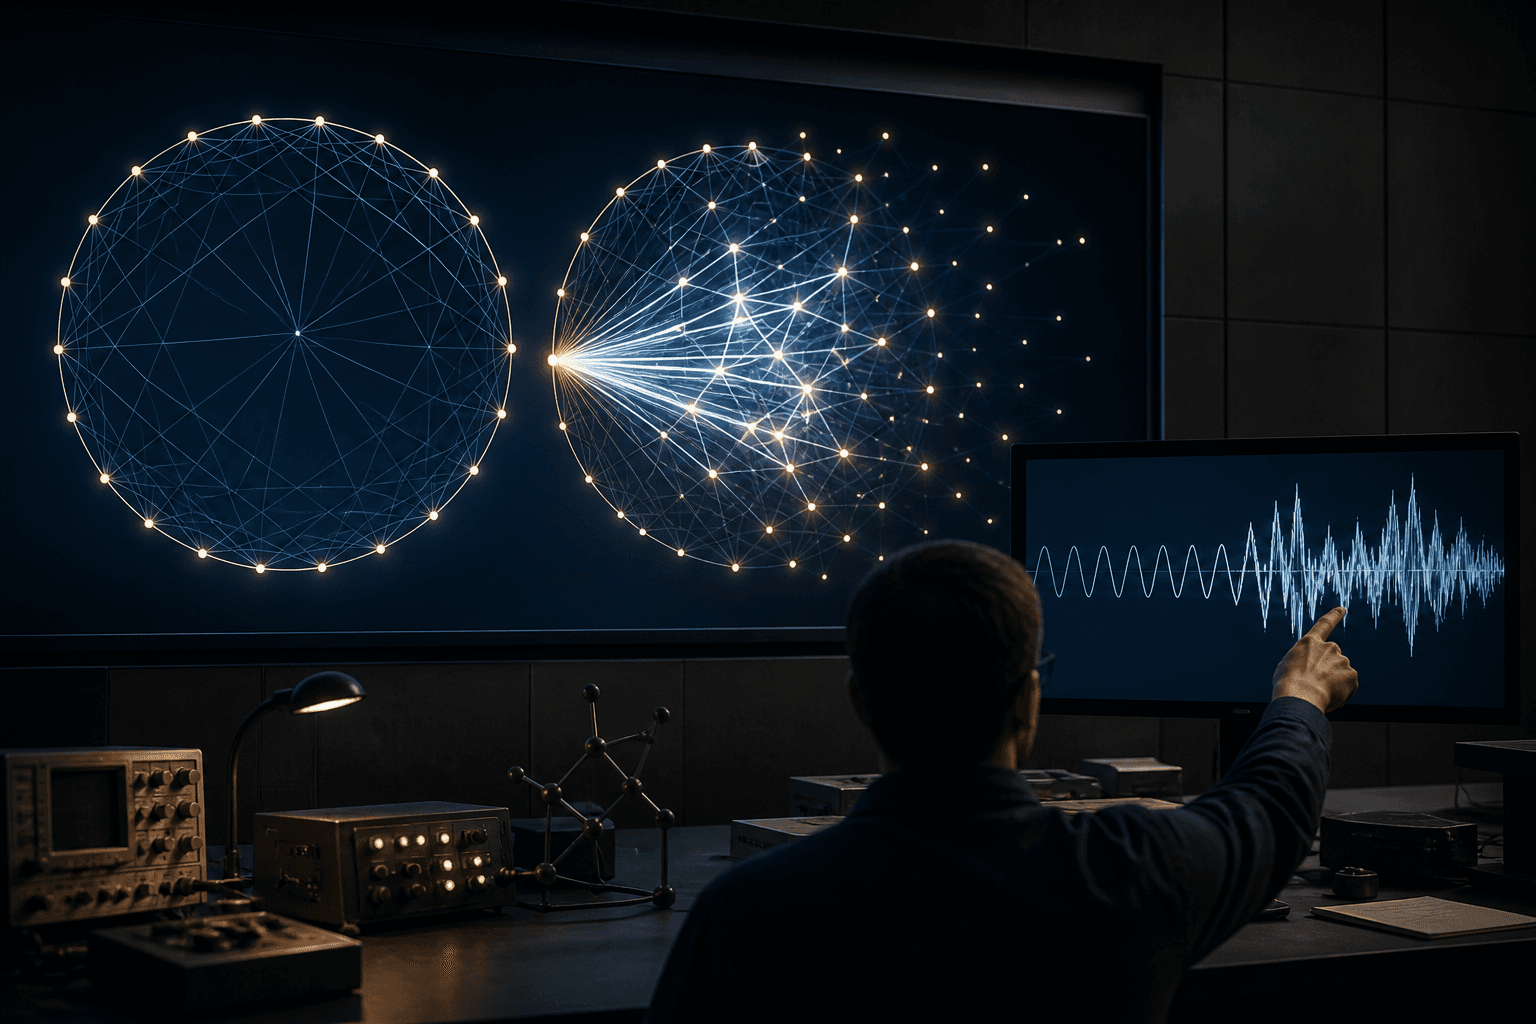
研究チームは、生成AIの中核技術であるトランスフォーマーを最小構成まで単純化し、その内部の時間発展を統計物理の手法で解析した。対象は、正規化された N 個のトークンが再帰的に更新される模型である。クエリとキーを恒等写像とし、値写像を負の恒等写像(V=-I)とした。類似した表現が注意で選ばれ、選ばれた場から遠ざかる向きにトークンが押し出される。この反発型のフィードバックが、表現の幾何構造と注意ネットワークを絶えず再編成する。
2次元ではトークンが円周上に並び、正多角形が厳密な固定点となる。注意フィードバックの強さγを上げると、多角形はフリップ分岐で安定性を失い、周期2の運動、カオス、クラスタの交換・反転状態が現れる。一方、ソフトマックスの鋭さβを有限に固定したまま N を無限大にすると、注意は拡散したままである。注意の凝縮が起きるのは、β が N の2乗に比例して大きくなる領域である。
ハードルーティング極限では、反発更新が局所的な摂動を増幅し、注意の相手の切り替わりがそれを弾道的に伝える。その結果、表現空間にバタフライ・コーンと呼ばれる影響の伝播領域が生じる。次元 d を N とともに無限大にした場合は、ガウス分布の初期条件からのシミュレーションで、β が O(1) の段階で凝縮転移が起きる証拠が得られた。γ に応じて、拡散したシンプレックス状の状態、合意反転、カオスの兆候を伴う凝縮活性ルーティング、断片化したクラスタ反転といった相が現れる。
著者らは、時間的活動、注意凝縮、幾何学的クラスタリングを別個の集団現象と位置づけた。そして、疎な注意は動的挙動を凍結させず、むしろ持続させうると結論づけた。
ビジネスへの示唆
本研究は単純化した模型の理論解析であり、実在の大規模言語モデルや事業成果を直接検証したものではない。以下は、成果から導かれる応用上の論点である。
第一に、AIモデルを開発・運用する企業の研究開発部門やMLOps部門である。長文処理のコストを抑えるため、注意を疎にする設計が広がっている。本研究は、注意が集中する条件と拡散する条件が、モデル規模と β のスケーリングで質的に異なることを示した。注意の集中度を診断指標として監視すれば、設計判断の根拠となりうる。関連するKPIは次のとおりである。
- 1トークン当たり推論コスト、応答遅延、GPU稼働率
- 学習の安定性(損失の発散率、再学習回数)
第二に、AIガバナンスや品質保証の部門である。出力を入力へ戻す反復処理では、条件次第でカオス的な挙動が持続する可能性が示された。自律的に複数工程を繰り返すエージェント型システムを、金融機関の与信審査支援やコールセンターの応対要約に導入する場合、微小な入力差が出力の大きな差へ拡大しうる。同一入力に対する出力の再現率、ハルシネーション率、タスク完遂率を、入力への摂動試験と組み合わせて測る運用が求められる。バタフライ・コーンの考え方は、影響の波及範囲を定量化する発想として参考になる。
第三に、推薦・検索を担う小売やメディアのマーケティング部門である。反発型の更新は似たものから遠ざかる動きにあたり、推薦結果の多様性を保つ仕組みと構造が近い。ただしこれは類推にとどまり、本研究が推薦システムを扱ったわけではない。
今後の展望
課題は、簡略化の前提を外した検証である。本研究はクエリとキーを恒等写像、値写像を負に固定しており、学習済みの実モデルでは重み行列が多様である。実際のモデルで同様の相転移や注意凝縮が観測されるかが、次の焦点となる。実証が進めば、モデル規模や温度設定を調整して挙動を安定化させる指針を、産業界が得られる可能性がある。それまでは、理論上の警告として、反復型AIの出力ばらつきを事前に評価する体制の整備が現実的な対応である。
関連トピック
同セクションの記事
正答率の高いAIほど規則の順序を区別
数学規則の並べ替えで答えが変わらない問題でも、正答率の高い言語モデルほど並び順を内部で区別して表現していることが、16モデルの分析で分かった。答えの一致だけでは推論の中身を測れない可能性を示す。
LLMの実行時挙動推論、最高精度37%にとどまる
研究チームは、実在するPythonリポジトリ12件から480問を作成した新ベンチマーク「SWE-Flux」を公表した。5種のLLMのうち最高の正答率は37%で、プログラム実行時の挙動の理解に課題が残ることが示された。
トランスダクティブ学習の誤差上界を改善
Yingzhen Yang氏が、手元の未ラベルデータの予測精度を扱うトランスダクティブ学習で、従来より鋭い誤差上界を導出した。必要なラベル数の理論的な見積もり精度が高まる。