AI自己蒸留、多様性低下の罠
最先端のAI訓練手法「自己蒸留」が平均精度を高める一方、モデルの回答多様性を密かに損なうことが判明した。企業のAI活用戦略と品質評価指標の見直しを迫る研究成果である。

研究の概要
カナダ・モントリオール大学らの研究チームは、大規模言語モデル(LLM)の訓練手法として注目される「オンポリシー自己蒸留(On-Policy Self-Distillation)」に潜在的な欠陥があることを理論・実験の両面から示した。
自己蒸留とは、同一モデルが「教師」と「生徒」の双方を兼ねる訓練方式である。教師役は正解例を参照しながら生徒役の出力にトークン単位で密度の高いフィードバックを与えるため、pass@1(1回の生成で正解する確率)を効率的に高められる手法として企業導入が進んでいた。
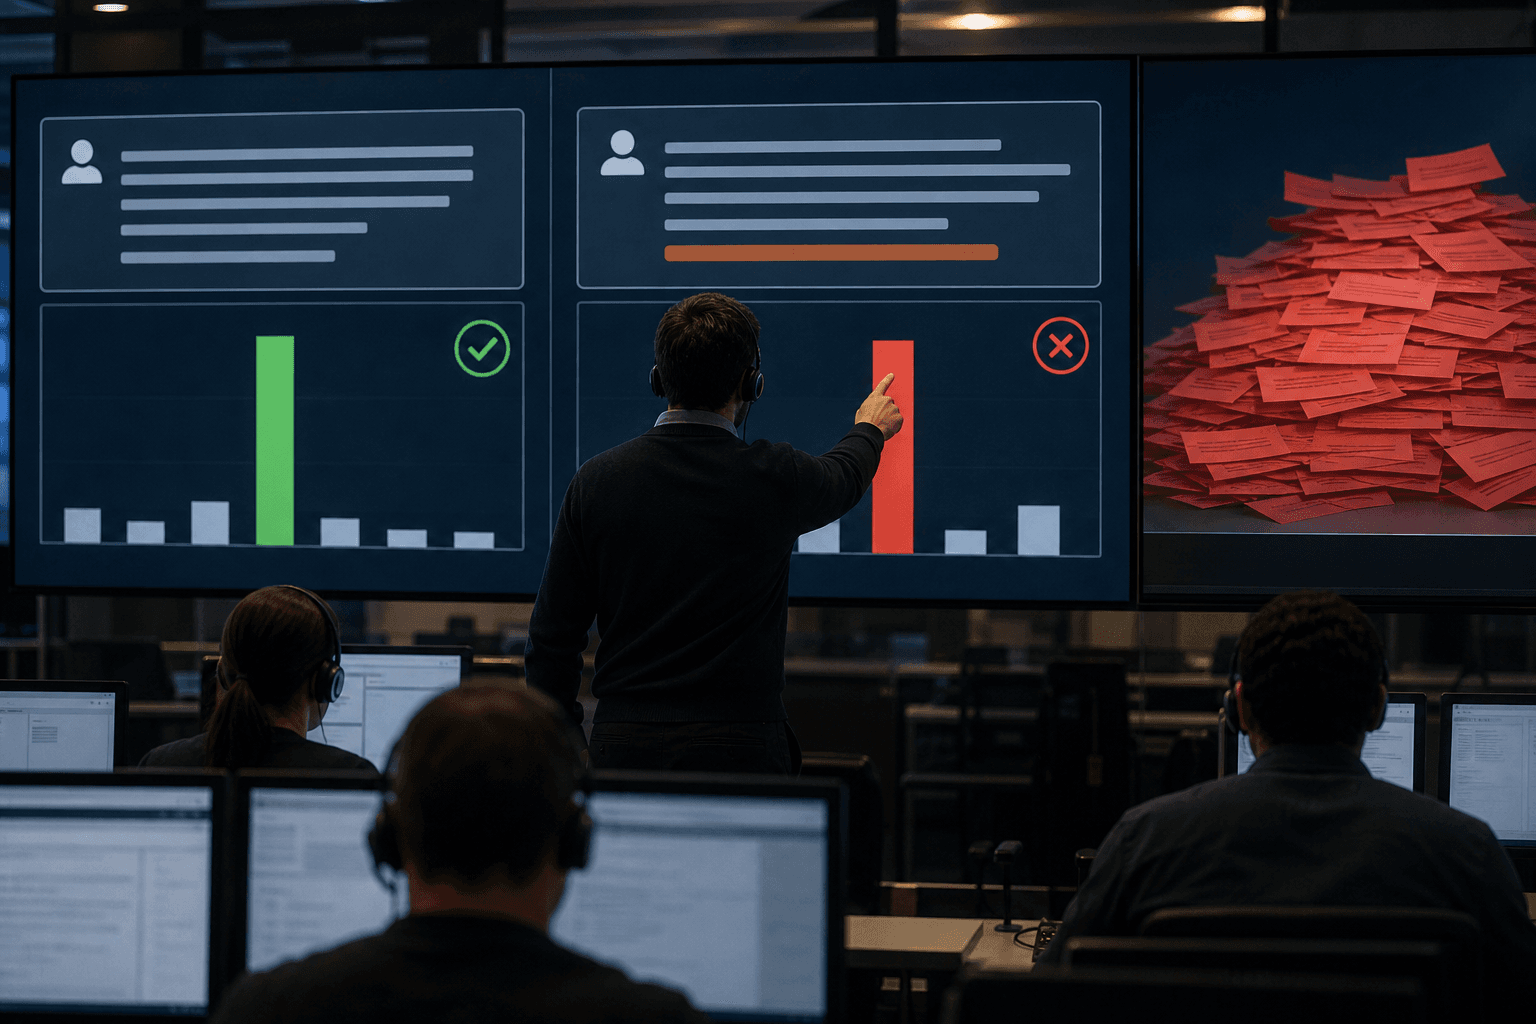
しかし研究チームは、この手法が「ロールアウト多様性」を著しく低下させることを発見した。具体的には、複数の回答を生成させても精度が頭打ちになる「pass@k曲線の平坦化」が生じる。理論分析によれば、教師が自身のバイアスを通じてフィードバックを与えるため、すでに確率の高い回答パターンへの集中が加速し、等しく正しい複数の解法の間で存在すべき確率バランスが崩壊する。グラフ経路探索タスクおよび科学的質問応答ベンチマークにおいて、自己蒸留モデルは強化学習(RL)と同等以上の平均スコアを示したが、分布外設定では多様な戦略を要求される問題への対応が顕著に劣ることが確認された。
ビジネスへの示唆
この研究が実務に与える影響は広範にわたる。特に以下の部門・業種では早急な評価指標の再設計が求められる。
- 法務・コンプライアンス部門:契約リスクの洗い出しや規制対応の検討では、複数の異なる視点からの回答生成が不可欠である。自己蒸留モデルは平均的な精度こそ高いが、想定外のリスクシナリオを見落とす可能性が高まる。
- 金融機関のリスク管理部門:市場急変や前例のない経済事象への対応策立案においても、多様な戦略シナリオの生成能力が直接的に業務価値を左右する。
- 製薬・医療機器メーカーのR&D部門:創薬候補の探索や副作用仮説の生成など、分布外の知識領域での推論が求められる用途では、多様性の低下が重大なリスク要因となりうる。
評価KPIとしては、従来のpass@1一辺倒から**pass@k(k≧5)**や回答の意味的多様性指標(Semantic Diversity Score)を併用する体制への移行が急務である。AIベンダーとの調達・導入契約においても、多様性指標の開示を要件化する動きが今後加速するとみられる。
コスト効率を優先してpass@1のみで評価・選定されたモデルが、実運用の本番環境で想定外の問題に遭遇するリスクは「隠れたコスト」として財務的影響を及ぼしかねない。
今後の展望
研究チームは自己蒸留と強化学習を組み合わせたハイブリッド訓練の可能性を示唆しており、精度と多様性のトレードオフを制御可能にするアーキテクチャ改善が次の焦点となる。
企業側には、用途に応じた訓練手法の選択眼が求められる時代に入った。定型業務の自動化にはpass@1最大化が合理的である一方、戦略立案・リスク分析・創造的業務といった高付加価値領域では多様性を担保した評価・調達基準の整備が不可欠である。AI導入効果を測るKPI設計そのものが、競争優位の源泉となりつつある。
関連トピック
同セクションの記事
微小介入でAI応答を制御、品質劣化防ぐ新手法
米ジョンズ・ホプキンス大学などの研究チームが、大規模言語モデルを再学習せずに出力傾向を調整する手法「MISVO」を発表した。低コストで応答品質を維持したまま報酬を最適化でき、企業のAI運用コスト削減につながる可能性がある。
PoEM、AI再学習なしで挙動予測
MITなどの研究チームが、既存の強化学習済みモデル群から新たな報酬関数向けの学習結果を追加学習なしに予測する手法「PoEM」を提案した。生成AI開発における再学習コストの圧縮と迅速な報酬設計の検証を可能にする。
自然な文脈で意思決定AIの判断が反転する
短く自然な文脈を付け足すだけで、正解していた意思決定AIの判断を高確信度の誤答へ誘導できるとの研究結果が公表された。AIの確率出力を業務判断の根拠とする企業に、運用の再考を促す内容である。