LLMの確率と正確性、乖離を解明
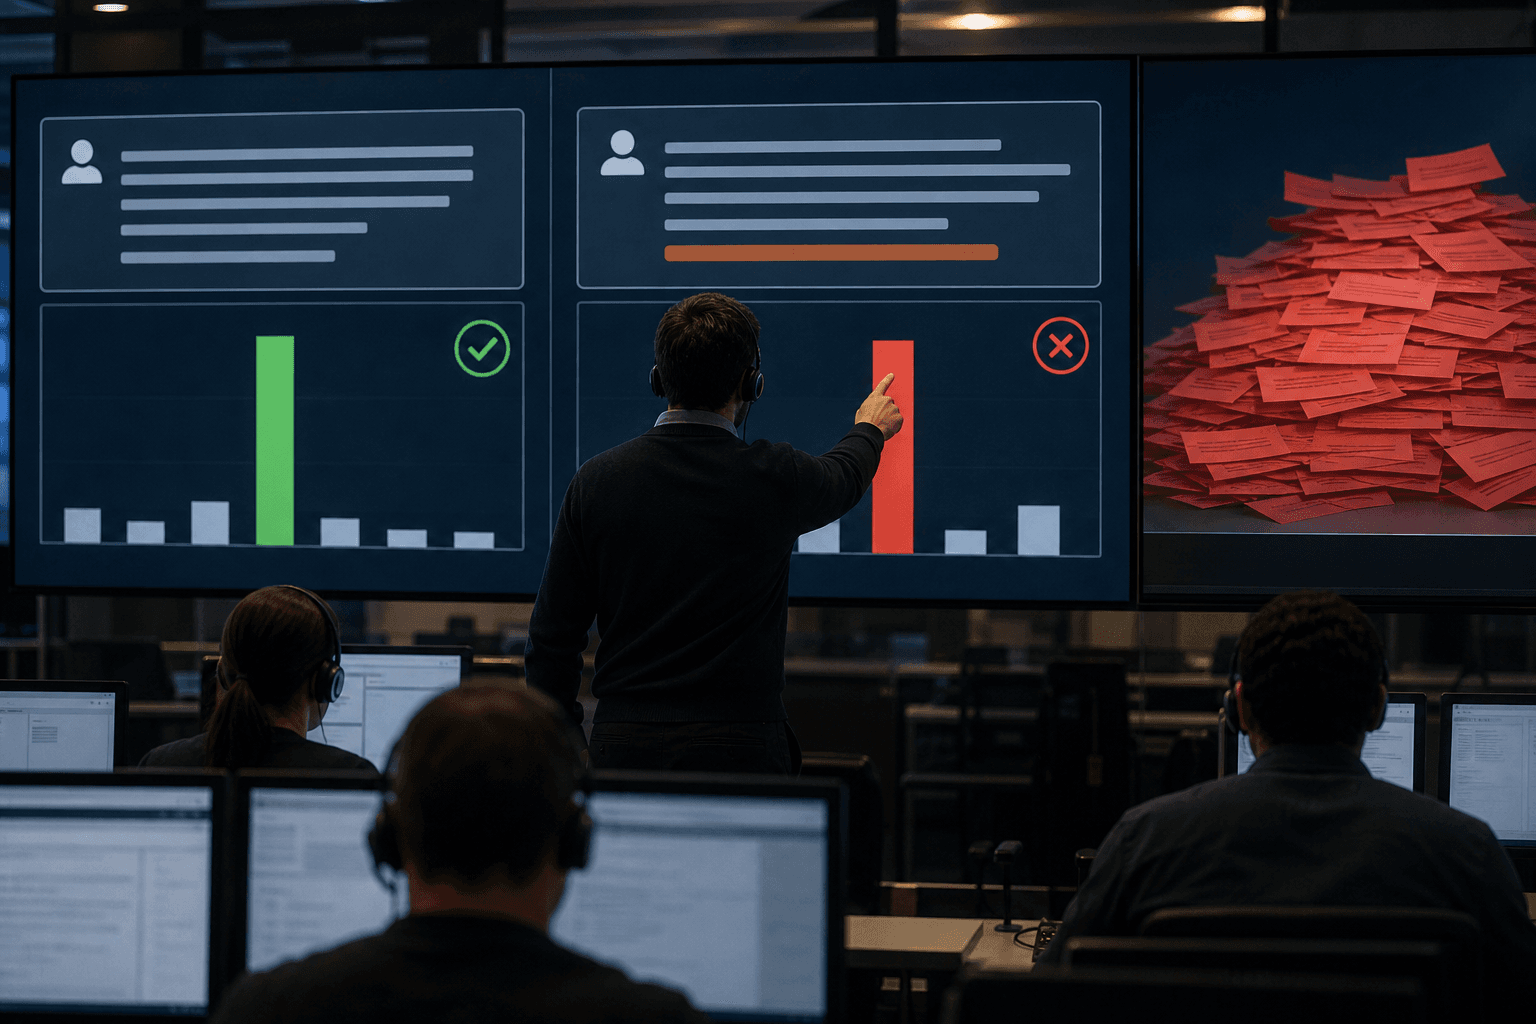
大規模言語モデルが「最も確からしい」と判断した出力が、必ずしも正しい答えを意味しないことを定量的に示した研究が発表された。企業のAI導入戦略と品質管理に直接影響する知見である。

研究の概要
独マックス・プランク研究所のJohannes Zenn氏らは、大規模言語モデル(LLM)が生成する出力の「シーケンス確率」と回答の正確性との関係を体系的に検証した論文を発表した。シーケンス確率とは、あるプロンプトに対してモデルが特定の文字列を生成する条件付き確率であり、多くのデコーディング手法(出力生成の制御技術)はこの確率を高める方向に設計されている。
研究チームは複数のモデル、デコーディング手法、ベンチマークを用いて、シーケンス確率と正確性の対応関係を4つの水準で分析した。その結果、データセット内の異なるプロンプト間では確率の高さが正確性の予測因子となり得る一方、同一プロンプトへの繰り返し応答の間では確率は正確性の指標として機能しないことが判明した。また、ハイパーパラメータや手法を変更することで確率を引き上げても、回答精度の向上には一貫して結びつかないという重要な知見も得られた。
ビジネスへの示唆
この発見は、LLMを業務に組み込む企業にとって見過ごせない実務上の問題を提起する。現在、多くのシステム開発では「モデルが高い確率で生成した出力=信頼できる出力」という前提のもとにパイプラインが構築されている。しかし本研究はその前提に根拠がないケースを明確化しており、品質保証の設計を根本から見直す必要性を示している。
影響が大きいと考えられる領域は以下の通りである。
- 法務・コンプライアンス部門:契約書レビューや法令解釈にLLMを活用する場合、確率スコアによる自動承認フローは誤回答を見逃すリスクがある。人手によるサンプリング検証の割合をKPIとして設定し直す必要がある。
- 金融・リスク管理部門:融資審査や市場分析レポートの自動生成において、出力の信頼度スコアをシーケンス確率で代替している場合は精度指標(F1スコア・適合率)を別途計測する体制が求められる。
- カスタマーサポート・マーケティング部門:チャットボットや文章生成ツールで「自己整合性(self-consistency)」手法を採用している場合、同一プロンプトへの複数回答を多数決するアプローチの有効性に限界があることを認識すべきである。回答正確率や顧客満足度スコア(CSAT)を外部評価で定期的に検証することが重要となる。
一方、データセット横断でのシーケンス確率と正確性の相関は確認されており、問題の難易度や種別を分類するフィルタリング用途には確率が有効に機能する可能性がある。例えばFAQの自動振り分けや、回答難易度に応じたエスカレーション判定への応用は引き続き合理的な設計といえる。
今後の展望
本研究が提示した知見は、企業がLLMの「自己改善」機能に過度に依存することへの警鐘でもある。モデルが自身の出力を検証・修正する「ベリファイアフリー型自己改善」手法はコスト削減の観点から注目を集めているが、その有効性がシーケンス確率の信頼性に依存している点が改めて問われることになる。
AI調達・導入を検討する企業は、ベンダーからシーケンス確率や信頼度スコアを根拠とした精度保証を受けた際に、その適用条件を精査することが求められる。正確性の評価基準をモデル内部の確率指標に頼るのではなく、業務固有のテストセットと外部評価指標を組み合わせたガバナンス体制の構築が、実用化における競争優位の鍵となるだろう。
関連トピック
同セクションの記事
微小介入でAI応答を制御、品質劣化防ぐ新手法
米ジョンズ・ホプキンス大学などの研究チームが、大規模言語モデルを再学習せずに出力傾向を調整する手法「MISVO」を発表した。低コストで応答品質を維持したまま報酬を最適化でき、企業のAI運用コスト削減につながる可能性がある。
PoEM、AI再学習なしで挙動予測
MITなどの研究チームが、既存の強化学習済みモデル群から新たな報酬関数向けの学習結果を追加学習なしに予測する手法「PoEM」を提案した。生成AI開発における再学習コストの圧縮と迅速な報酬設計の検証を可能にする。
自然な文脈で意思決定AIの判断が反転する
短く自然な文脈を付け足すだけで、正解していた意思決定AIの判断を高確信度の誤答へ誘導できるとの研究結果が公表された。AIの確率出力を業務判断の根拠とする企業に、運用の再考を促す内容である。