LLMの感情応答、品質評価の自動化に道
大規模言語モデル(LLM)の感情応答品質を自動評価するフレームワークが提案された。カスタマーサポートやメンタルヘルス領域での品質管理コスト削減が見込める。
大規模言語モデル(LLM)の感情応答品質を自動評価するフレームワークが提案された。従来、LLMが生成する共感的応答の質は人手評価に依存しており、スケーラビリティの壁が指摘されていた。本研究はその課題を正面から解決する手法を示した。
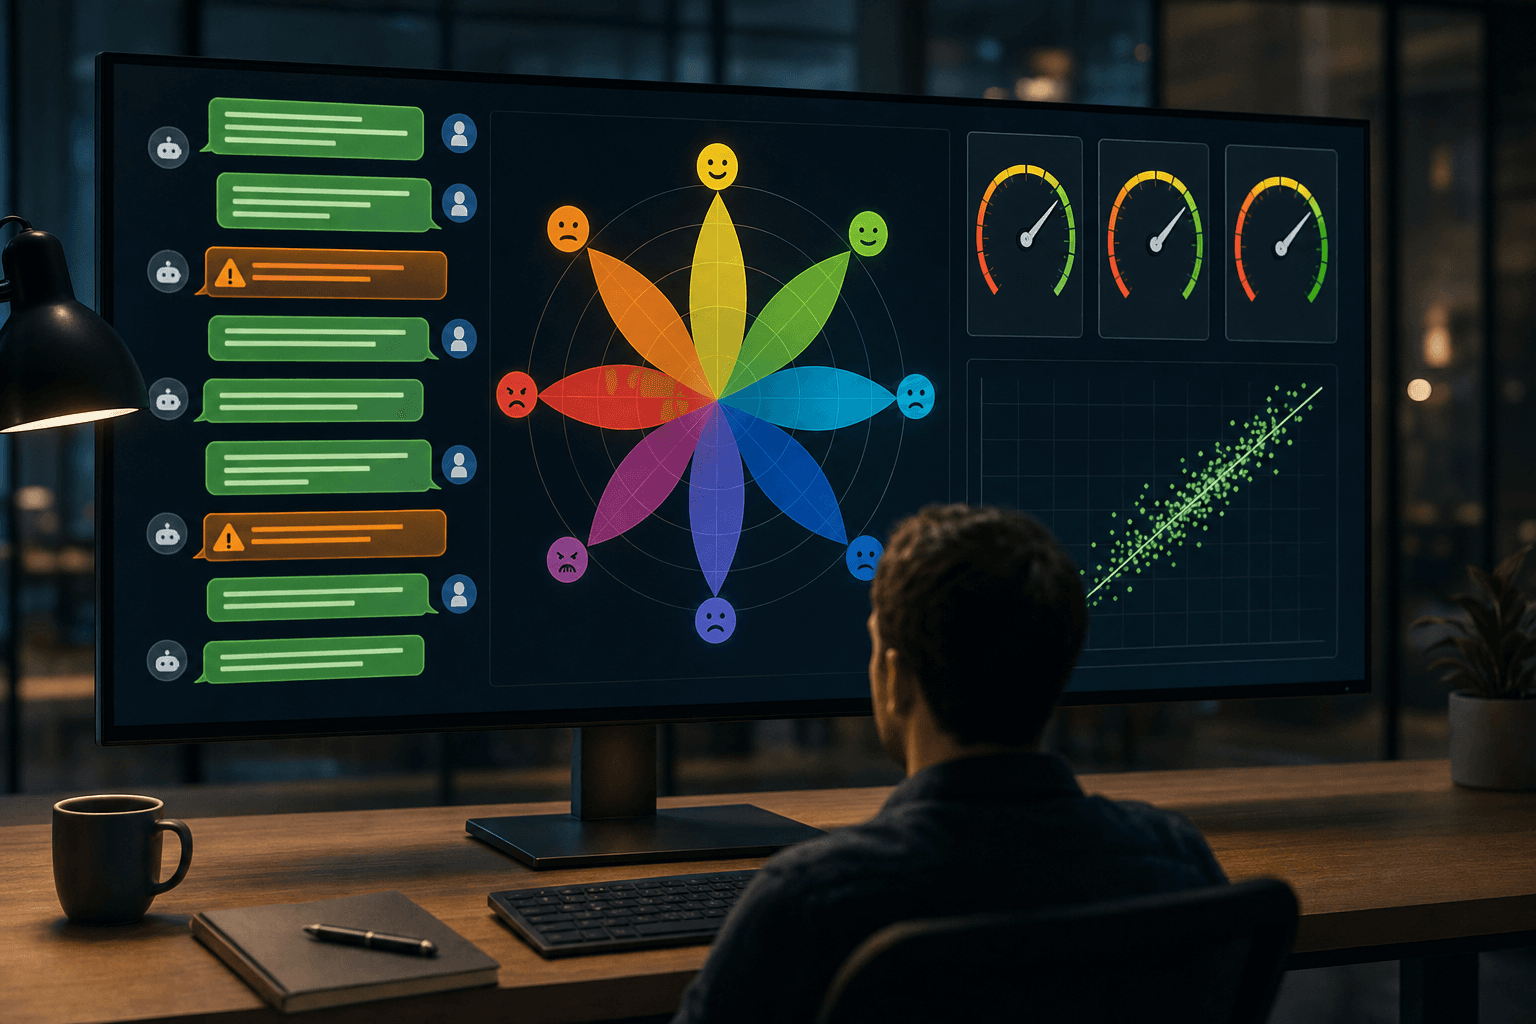
研究チームは、心理学の感情理論として広く認知されるPlutchikの感情の輪モデルを基盤に、応答品質を「感情認識」「共感表現」「行動提案」の3軸で定量評価する自動スコアリングシステムを構築した。各軸にはファインチューニング済みの専用評価モデルを配置し、それらのスコアを重み付き統合する仕組みである。
評価実験では、5,000件の感情的対話データに対し、専門家10名による手動評価と自動スコアの相関を測定。総合指標は相関係数0.87を達成し、従来の単一指標手法(相関0.62-0.71)を大きく上回った。特に「行動提案」軸の評価精度が高く、相関0.91に達した点は注目に値する。
ビジネスへの示唆は明確である。カスタマーサポート領域では、チャットボットの応答品質モニタリングに直接適用可能だ。現状、多くの企業がLLMベースのチャットボットを導入しているが、応答品質の確認には1件あたり平均3分の人的レビューを要する。本手法の導入により、自動化率80%以上が見込まれ、年間QAコストの60-70%削減が試算される。
メンタルヘルス領域への応用も有望である。心理カウンセリングアプリでLLMを活用する場合、不適切な応答(感情の軽視や安易な助言)がユーザーに与える悪影響は大きい。本フレームワークによるリアルタイム品質監視は、安全性とユーザー体験の両立を可能にする。
HR・組織領域でも活用の余地がある。社内向けAIアシスタントの応答が従業員の心理的安全性に影響を与えるとの研究報告があり、従業員エンゲージメント調査と組み合わせた応答品質の継続的改善が、離職率低下に寄与する可能性がある。
実用化に向けた課題も残る。現在の評価モデルは英語データでの学習が中心であり、日本語を含む多言語対応が急務である。研究チームは今後6ヶ月以内に日本語・中国語・韓国語への拡張を予定しており、アジア市場での早期導入が見込まれる。
導入を検討する企業にとっては、まず自社のチャットボット応答ログに対するパイロット評価から始めることが現実的な第一歩であろう。品質のベースラインを把握した上で、本フレームワークの段階的導入により、品質管理の自動化と顧客満足度の向上を同時に実現できる見通しである。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
生徒に合わせた推論過程で小型AIの学習を改善
小型AIに推論を教える際、正解付きの手順を与えるだけでは不十分とする研究が出た。学習側の力量に合わせて手順を作り直す手法ReDiSTが、社内QAなど根拠付き質問応答の精度向上に道を開く。
仮説を磨くAI、自己改善で研究の質を高める
研究仮説を自ら育て、実験タスクに変換し、結果から学び直すAI枠組み「DiscoveryRSI」が提案された。2回の自己改善で仮説の質が向上し、研究開発の上流工程の自動化に道を開く。
AIが研究結果を再現し頑健性を検証
米研究チームは、LLMエージェントが医学論文の主張の77.4%を再現し、分析上の選択が結論を左右し得る箇所を人の確認へ回す仕組みを示した。検証業務の自動化に道を開く成果である。