分子AI、環構造を文法化し創薬生成を高精度化
米スタンフォード大などの研究チームが、分子の環構造を生成規則の列として表現する新手法HGRを開発した。生成分子は常に有効で、創薬AIの基盤モデル性能も大幅に向上した。
研究の概要
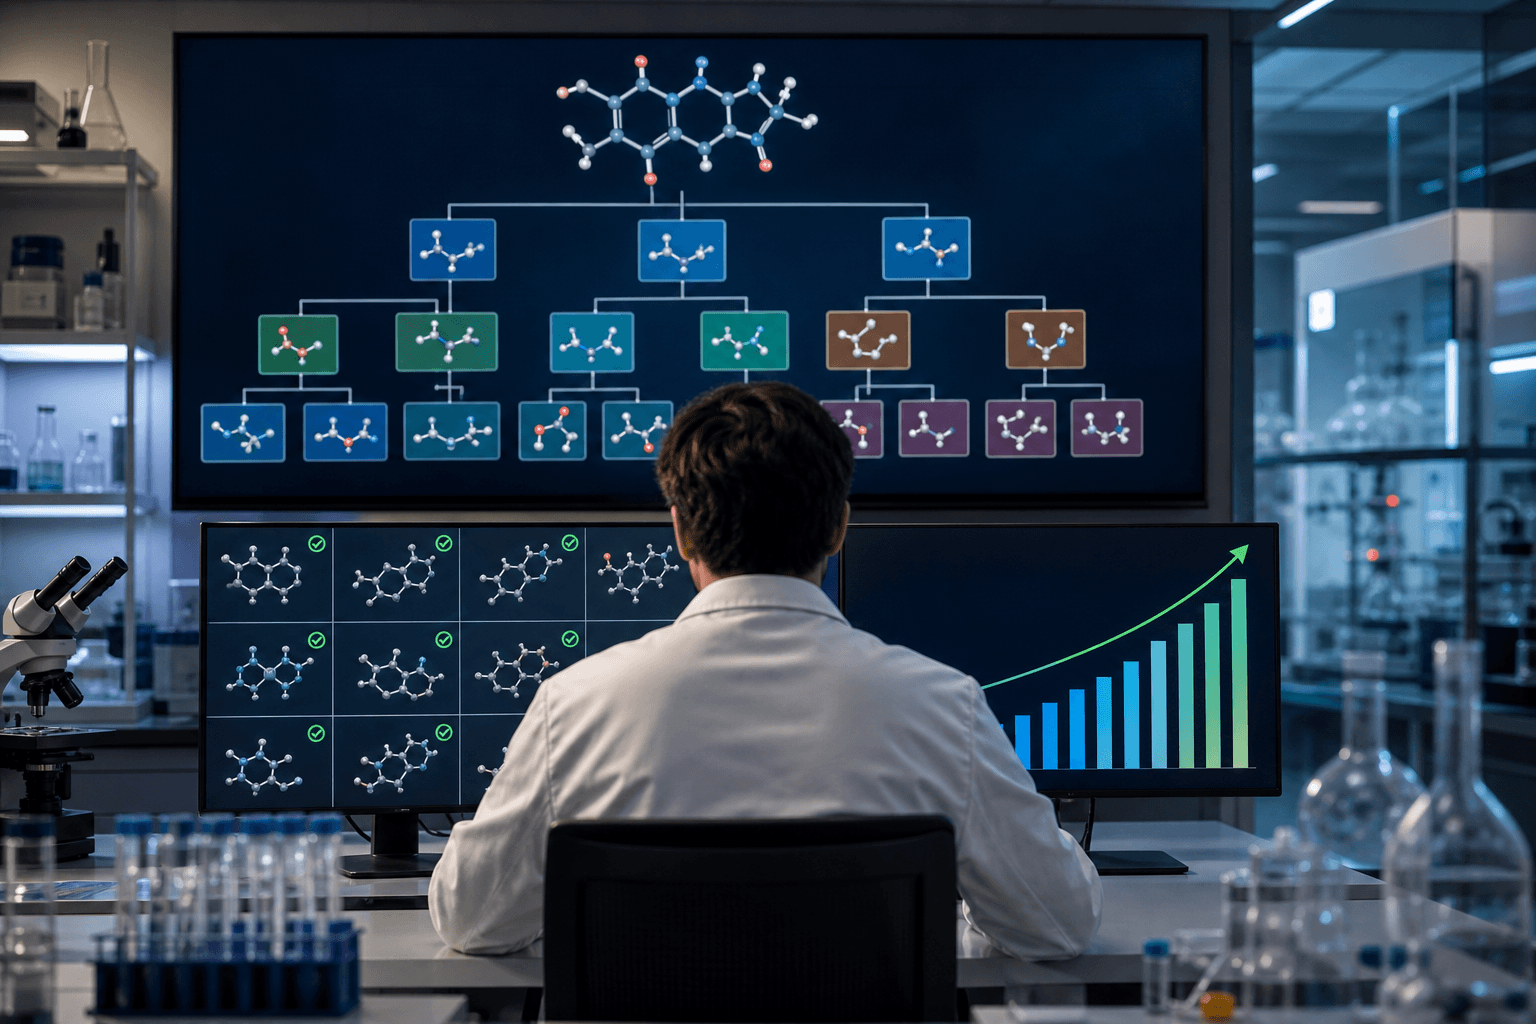
米スタンフォード大学のJure Leskovec氏らの研究チームは、分子を機械学習で扱うための新たな表現手法「高次文法表現(HGR)」を発表した。分子に含まれる環状構造や繰り返し現れる部分構造を、文脈自由文法に基づく生成規則の系列として記述する方式である。
従来の文字列表現やグラフ表現は、複数の環が縮合した環系や頻出モチーフといった高次のトポロジーを明示的に扱うことが苦手であった。高次構造を直接扱える既存手法も存在するが、計算負荷が大きく、生成結果を有効な分子へ復元することが難しいという課題を抱えていた。HGRは分子を組合せ複体として捉えたうえで規則の系列に変換するため、標準的な系列モデルをそのまま利用でき、計算コストの増大を避けながら構造情報を保持できる。
研究チームは評価用に、環構造を豊富に含む118万分子のベンチマーク「RingDiv」も構築した。環系の網羅度を測る環多様性指数(RDI)も新たに提案している。既存のベンチマークは単純な環に偏っているとの問題意識に基づく。
分子生成の実験では、HGRに基づくモデルは構造上100%の有効性を保証しつつ、生成分子の分布の近さを示すFCD指標で全5ベンチマークの首位となった。表現学習では、基盤モデルHGR-FMが7種のMoleculeNetベンチマークで最高の平均AUCを記録した。最強の比較手法に対し、特徴量を固定するプロービングで8.3ポイント、全体を再学習する完全微調整で3.3ポイント上回った。
ビジネスへの示唆
最も影響を受けるのは製薬・化学・素材業界である。創薬では、生成AIが出力した候補分子のうち無効な構造が一定割合を占め、後段の検証工程で人手や計算資源が消費されてきた。有効性が構造的に保証されれば、研究開発部門の候補化合物のスクリーニング効率が改善し、リード化合物探索にかかる期間の短縮が見込まれる。
医薬品には多環式骨格を持つ化合物が多く、天然物由来の医薬や農薬も複雑な環系を特徴とする。環構造の扱いに優れる表現は、これら領域で候補分子の多様性を高める可能性がある。
影響が想定される主な部門とKPIは次のとおりである。
- 創薬研究部門:ヒット率、候補化合物の有効分子率、探索サイクル日数
- ケモインフォマティクス部門:生成モデルの学習・推論コスト、予測精度(AUC)
- 素材開発部門:新規骨格の探索数、試作回数の削減率
- 知財部門:新規性を持つ化合物クレームの出願件数
表現学習の面でも意義は大きい。社内の実験データが少ない企業は、事前学習済みの基盤モデルを転移して活用する。プロービングで精度が大きく向上した点は、追加学習の計算資源が限られる中堅企業やスタートアップにとって、導入コストの低減につながる。毒性や溶解性など物性予測の精度向上は、前臨床段階での脱落リスクの早期把握にも資する。
今後の展望
今回の結果は公開ベンチマーク上の評価であり、実際の創薬現場での有用性は別途検証が必要である。生成分子が合成可能か、薬理活性や安全性の要件を満たすかは、有効性とは別の問題として残る。また、RingDiv上の優位性が、企業の保有する独自化合物ライブラリでも再現されるかは未確認である。
一方、生成規則の系列という形式は既存の言語モデル基盤と親和性が高い。大規模な化合物データで事前学習した基盤モデルを、自社データで微調整する運用に組み込みやすい。企業は自社データでの小規模な検証を先行して進め、候補分子の有効率や予測精度の改善幅を実測したうえで、導入の費用対効果を判断することが求められる。
関連トピック
同セクションの記事
天然変性領域の設計AIが機能制御を実現
天然変性タンパク質領域を生成する言語モデルIDiomと、解釈可能な特徴を報酬とする強化学習RL-SAEが発表された。標的特徴の活性化率は平均90%に達し、創薬や合成生物学の設計手法に影響を与える可能性がある。
脳解読AI、時間の近道除去で精度向上
非侵襲の脳波などから単語を復元する有力手法の精度向上は、脳データなしでもほぼ再現できることが判明した。研究チームは近道を除く簡素な改良で、単語誤り率36.6%を達成した。
順位指標でAI診断プロンプトを最適化
医療向けマルチモーダルAIのプロンプト改善で、正解率ではなくAUROCを最適化する手法Ranking-PEが提案された。不均衡な臨床データで診断の順位付け精度を最大16.2ポイント高めた。