ゲームAI評価基盤、企業導入の物差しに
テンセント系列を含む研究チームがAAAゲーム21種・5000時間分の映像と指示文からなるAI評価基盤「GameHorizon」を公開した。47モデルを100万回超比較し、長期計画能力の格差を可視化。エージェントAI選定の客観指標として注目される。
研究の概要
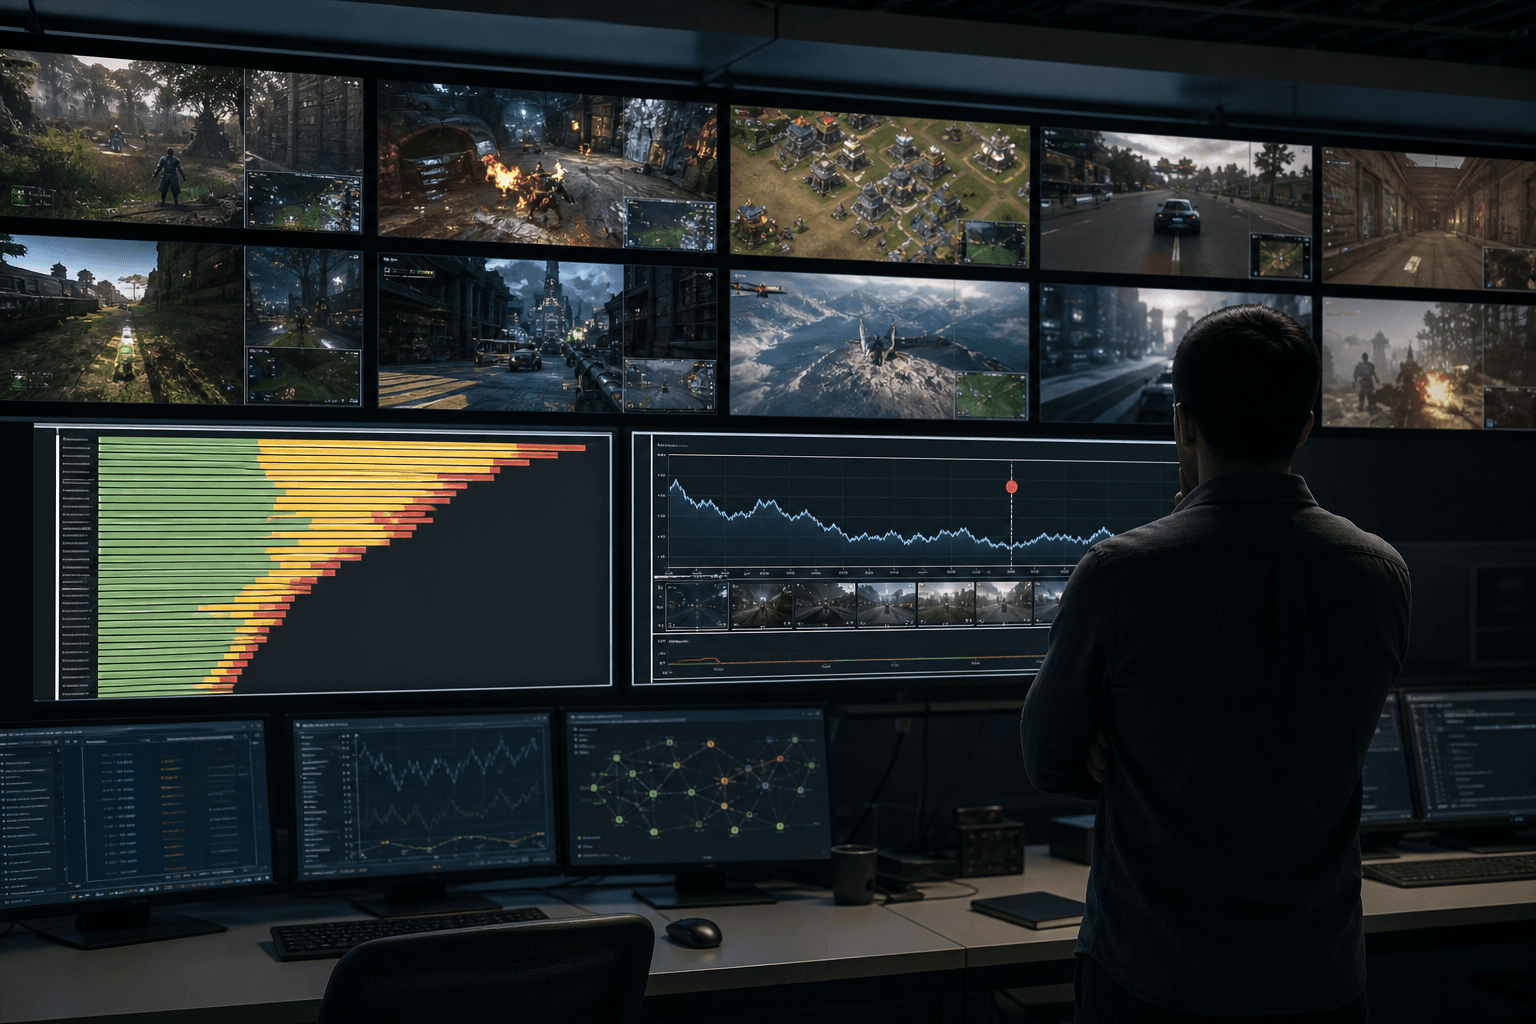
中国の研究チームが、ゲームプレイを通じてAIモデルの視覚理解・指示分解・目標計画・行動制御能力を測定する統合データ評価基盤「GameHorizon Suite」を発表した。同スイートは、指示文を自動生成する注釈パイプライン「GameHorizon-Annotator」、100人の熟練プレイヤーが21種のAAAタイトルをプレイした映像・操作ログ・多段階指示を収録した「GameHorizon-Data」(総収録時間5000時間)、そして再現可能なオフライン評価とステップ単位のオンライン評価を組み合わせた「GameHorizon-Bench」の3要素で構成される。研究チームは同基盤を用いて47モデルに対し延べ100万回を超える推論を実施し、タスクの難易度階層とモデル間の能力差を定量的に明らかにした。特徴的なのは、短期の即時操作から長時間にわたる目標達成まで複数の時間軸(マルチホライズン)で評価する点であり、従来のオンライン試行だけに依存した評価が抱えていた再現性の低さという課題を解消している。
ビジネスへの示唆
この成果は単なるゲーム研究にとどまらず、複数の産業に実務的な影響を及ぼす。第一にゲーム開発業界では、品質保証(QA)部門が自動プレイテストにAIモデルを活用する際、どのモデルが長時間シナリオでバグを検出しやすいかを客観的に比較できるようになり、QAサイクルの短縮とテスト工数の削減が期待できる。第二に、NPC(ノンプレイヤーキャラクター)や対話型ゲームAIを開発する部門にとって、指示追従精度や行動制御の一貫性を数値化できる点は、外部AIベンダー選定時の調達基準として機能する。
第三に、より広範なエンタープライズAIエージェント導入への波及効果が大きい。業務自動化(RPA)やカスタマーサポート向けエージェントは、複数ステップにわたる指示を破綻なく遂行できるかが導入の可否を左右するため、GameHorizonが提示する「ステップ単位で失敗箇所を特定する」評価手法は、企業内でAIエージェントの信頼性を検証する枠組みとして転用できる。関連するKPIとしては、以下が挙げられる。
- タスク完遂率(長期指示の最終達成度)
- ステップ単位の誤り率(中間工程での失敗頻度)
- 指示理解の再現性(同一条件下でのスコア安定性)
第四に、製造・物流分野のロボティクス部門にとっても、ゲーム環境は実機投入前の低コストな検証場として活用できる。長期計画を要する組立・搬送タスクの事前評価に、同様のマルチホライズン評価手法を応用する余地がある。
今後の展望
研究チームはデータセット・注釈パイプライン・ベンチマークを公開する方針を示しており、今後は国内外のゲーム会社やAIベンダーがこれを共通の評価尺度として採用するかが焦点となる。標準化が進めば、AI人材の採用基準や研究開発投資の意思決定において「どの時間軸の能力が不足しているか」を可視化した比較が可能になり、経営層のAI投資判断を支える材料となり得る。一方で、著作権を持つゲームタイトルの映像・操作データを扱う以上、ライセンス関係や利用範囲の整理は今後の実運用における課題として残る。
関連トピック
同セクションの記事
端末AI個人化、ハイパーネット新手法
米グーグル研究チームが、スマートフォン上で個人ごとの大規模言語モデルを高速生成する新手法を発表した。計算負荷を抑えつつ精度を高め、モバイルAI活用に新たな道を開く。
onPanda、AI調整データ作成時間半減
中国の研究チームが、LLM応答をトークン単位で修正しながら効率的にアノテーションできるツール「onPanda」を発表。手作業の後編集に比べ作業時間の中央値を52%削減し、AI開発現場のコスト構造に影響を与える可能性がある。
AIエージェント訓練、介入好機をAIが診断
サレスフォースなど研究チームが、複数手順にまたがるAIエージェントの対話のうち、どの発話を訓練すべきかを診断する新手法「Critical-State RL」を発表した。誤った地点で訓練すると成果が横ばいか悪化する一方、正しい地点を選べば最大約14ポイントの精度向上を確認した。