深宇宙中継の送信順を強化学習で最適化
間欠的な通信と限られた蓄積容量の下で、どのデータを先に送るかを強化学習で決める枠組みが提案された。情報の鮮度と送信元間の公平性が、従来方式より改善したという。
研究の概要
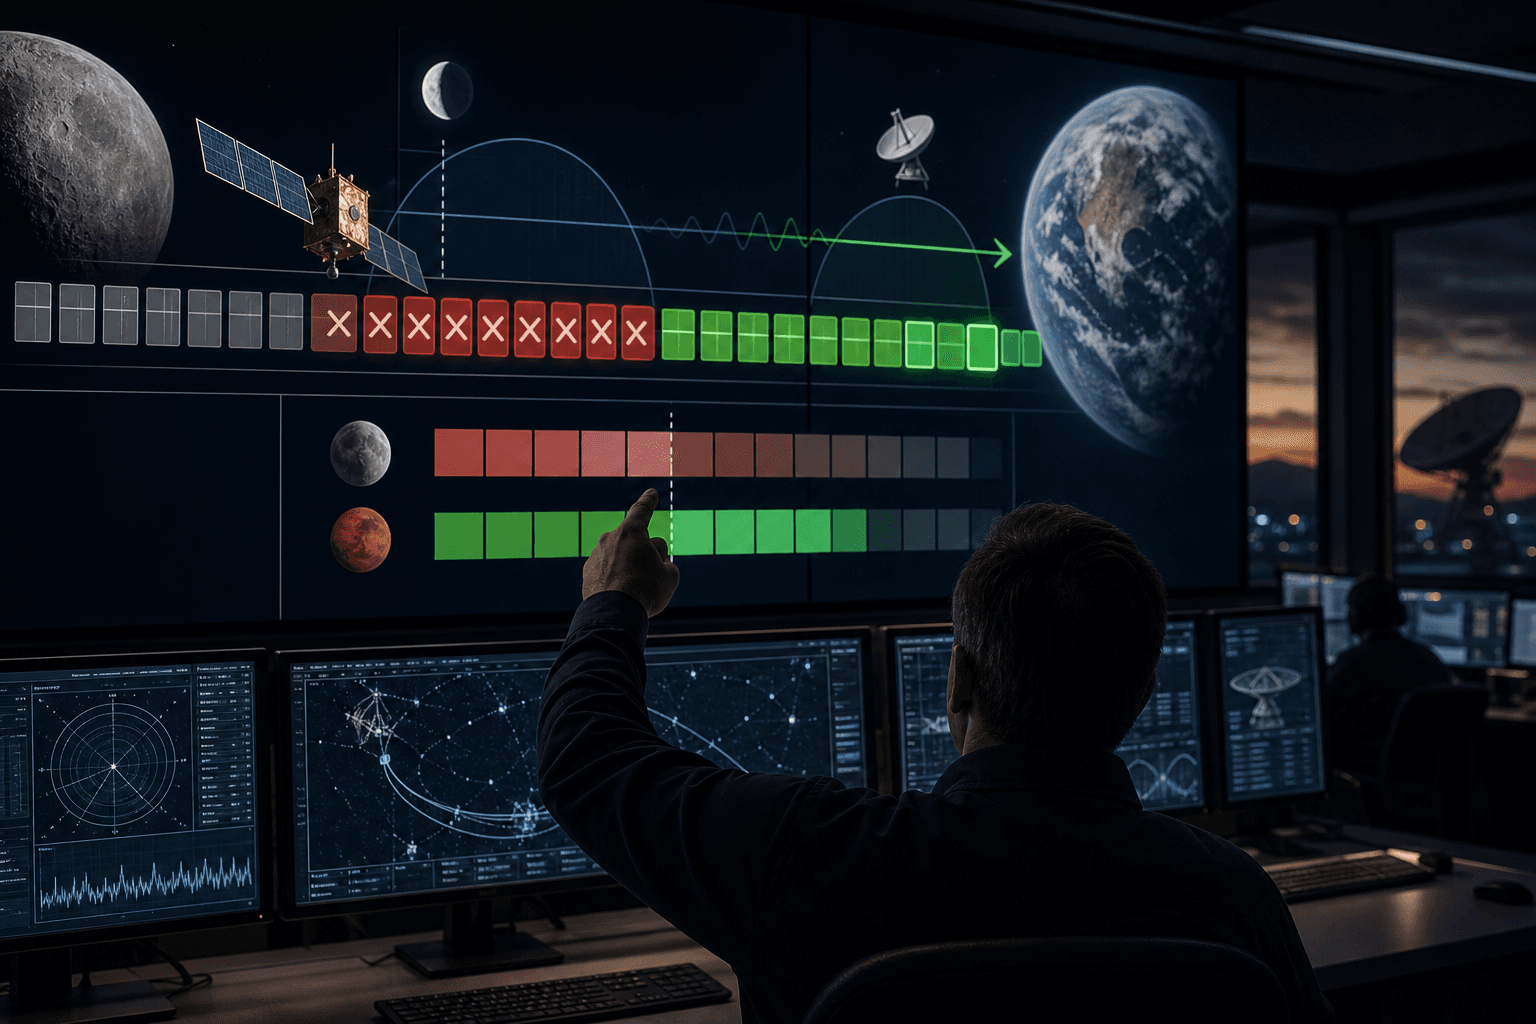
深宇宙通信では、通信できる時間帯が断続的で、伝搬遅延も長く、中継機の蓄積容量にも限りがある。こうした環境では、Bundle Protocolと呼ばれる「蓄積・運搬・転送」方式が使われる。中継ノードはデータの塊(バンドル)を一時的に預かり、通信窓が開いたときに地球へ転送する。
Baghaeeらの研究は、月と火星からの更新情報を共有バッファの中継機経由で地球へ送る状況を対象とし、中継側の「何を送り、何を捨て、どの流れを絞るか」を一括して学習させる枠組みを示した。従来のFIFO(先着順)は到着順に処理するだけで、任務上の価値を考慮せず、送信元が異なると不公平な扱いになりやすい。
評価指標には、受信側での情報の鮮度を表す超過年齢を用いる。情報年齢(Age of Information)から、送信元ごとに避けられない遅延の基準値を差し引き、負の値は零とする。月と火星では物理的な遅延が大きく異なるため、この補正により不当な不利を避けられる。さらに送信元ごとに非線形のペナルティを設定でき、任務上の重要度に応じた優先づけが可能となる。
しくみをやさしく
制御問題は、制約付き半マルコフ決定過程(CSMDP)として定式化されている。通常の強化学習は一定間隔で判断するが、半マルコフ型は通信窓の開閉のように判断の間隔が不規則な場面を扱える。学習にはPPOという代表的な手法を用い、制約をラグランジュ乗数で扱う。つまり「鮮度を良くしたい」という目的と、「バッファ容量や公平性を守る」という条件を同時に調整しながら方策を磨く。
工夫の要は実行可能性を考慮した行動マスクである。残りの通信窓内で送り終えられないバンドルは、あらかじめ選択肢から外す。途中で切れて無駄になる送信を最初から排除することで、学習の探索範囲が狭まり、安定した学習につながる。DTNSimによるシミュレーションでは、年齢に基づく効用と流れ間の公平性が、基準となる各種スケジューラより改善したと報告されている。
ビジネスへの示唆
本研究の本質は、深宇宙に限らず「資源が限られ、締め切り付きの窓があり、種類の違う依頼が競合する」場面での割り当て問題にある。自部署に当てはめるなら、次の問いになる。いま先着順や担当者の勘で処理している業務のうち、価値の高いものが後回しになっていないか。誰が、どれだけの手間をかけて順番を決めているか。
該当しやすい業務は多い。
- 物流・運輸の配車や倉庫出荷:配送枠が限られる中での出荷順の判断。指標は定時到着率や緊急便の遅延
- 通信・IoT運用:電波や回線が不安定な拠点からのセンサーデータ集約。指標はデータ鮮度や欠損率
- 製造の保全部門:複数ラインからの異常通知の処理順。指標は停止時間や対応までの待ち時間
- カスタマーサポート:問い合わせの優先順位づけ。指標は初回応答時間や拠点間の対応格差
特に超過年齢の考え方は、「拠点ごとに避けられない遅れ」を差し引いて評価する発想として応用しやすい。遠隔拠点が常に低評価になる不公平を避けつつ、真に改善すべき遅れだけを可視化できる。
現場での導入イメージ
仮に導入支援に入るなら、次のような流れが現実的である。
-
棚卸し:順番待ちや取りこぼしが生じている業務を洗い出し、現在の処理ルールと、判断に要している人手を可視化する。目指す到達点は、「どの種類の依頼が、なぜ後回しになるか」を関係者が共通認識として持てる状態である。
-
差し込み先の設計:新しいツールを増やさず、既存のチケット管理や配車・出荷システムの「順番決定」部分だけを置き換える形を優先する。鮮度や重要度の定義、守るべき制約(容量・期限・公平性)を業務側と合意する。目指す到達点は、現行の運用を崩さずに推奨順位を出せる構成である。
-
小さく試す(PoC):一部署・数週間に限り、過去データによるシミュレーションと、担当者への推奨表示から始める。実行不能な選択肢を除く行動マスクの考え方を、業務ルールとして先に組み込む。目指す到達点は、担当者が「この順番なら納得できる」と実感できるかの確認である。
-
運用と横展開:評価基準と例外対応の手順を整え、効果が見えた業務から他部署へ広げる。目指す到達点は、優先順位の判断が属人的な勘から、説明可能な基準に基づく運用へ移った状態である。
全体として目指すのは、限られた処理能力を、価値の高い依頼へ公平かつ根拠をもって配分できる職場である。小さく安く始め、効果を担当者の実感で確かめながら進められる点が利点となる。
今後の展望
本成果はシミュレーションによる検証であり、実機の運用や商用環境での有効性は今後の課題である。ただし、通信が途切れがちな環境での優先制御は、衛星通信、災害時ネットワーク、遠隔地のIoTなど地上でも需要が見込まれる。鮮度と公平性を同時に扱う設計思想は、業種を越えて参考になるとみられる。
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
Q学習の最終出力、必要データ量を証明
単一の行動履歴だけで学ぶQ学習について、最終的に得られる表の精度を保証するデータ量の上界が示された。初期化コストが加算で済むことを証明しており、実運用の見積もり根拠となる。
表データ回帰、分位点損失が安定して優位
表形式データの深層学習による回帰で、多くの代替損失はMSEを上回らず、分位点損失だけが一貫して改善した。領域ごとに最適な学習停止時期が異なる点も示された。
VLM、空間関係を埋め込みで喪失と判明
視覚言語モデルは画像内の「上」「隣」といった空間関係を、下流で使う文表現の段階で語彙情報より大きく失うことが判明した。出力評価では見えない欠陥である。