拡散モデル、教師データなしで物理場を学習
拡散モデルを学習済みデータなしで訓練する手法が、格子場理論の計算で従来のHMCデータ学習と同等の性能を示した。重い事前サンプリングを省く設計思想は、シミュレーション負荷に悩む産業に波及し得る。
研究の概要
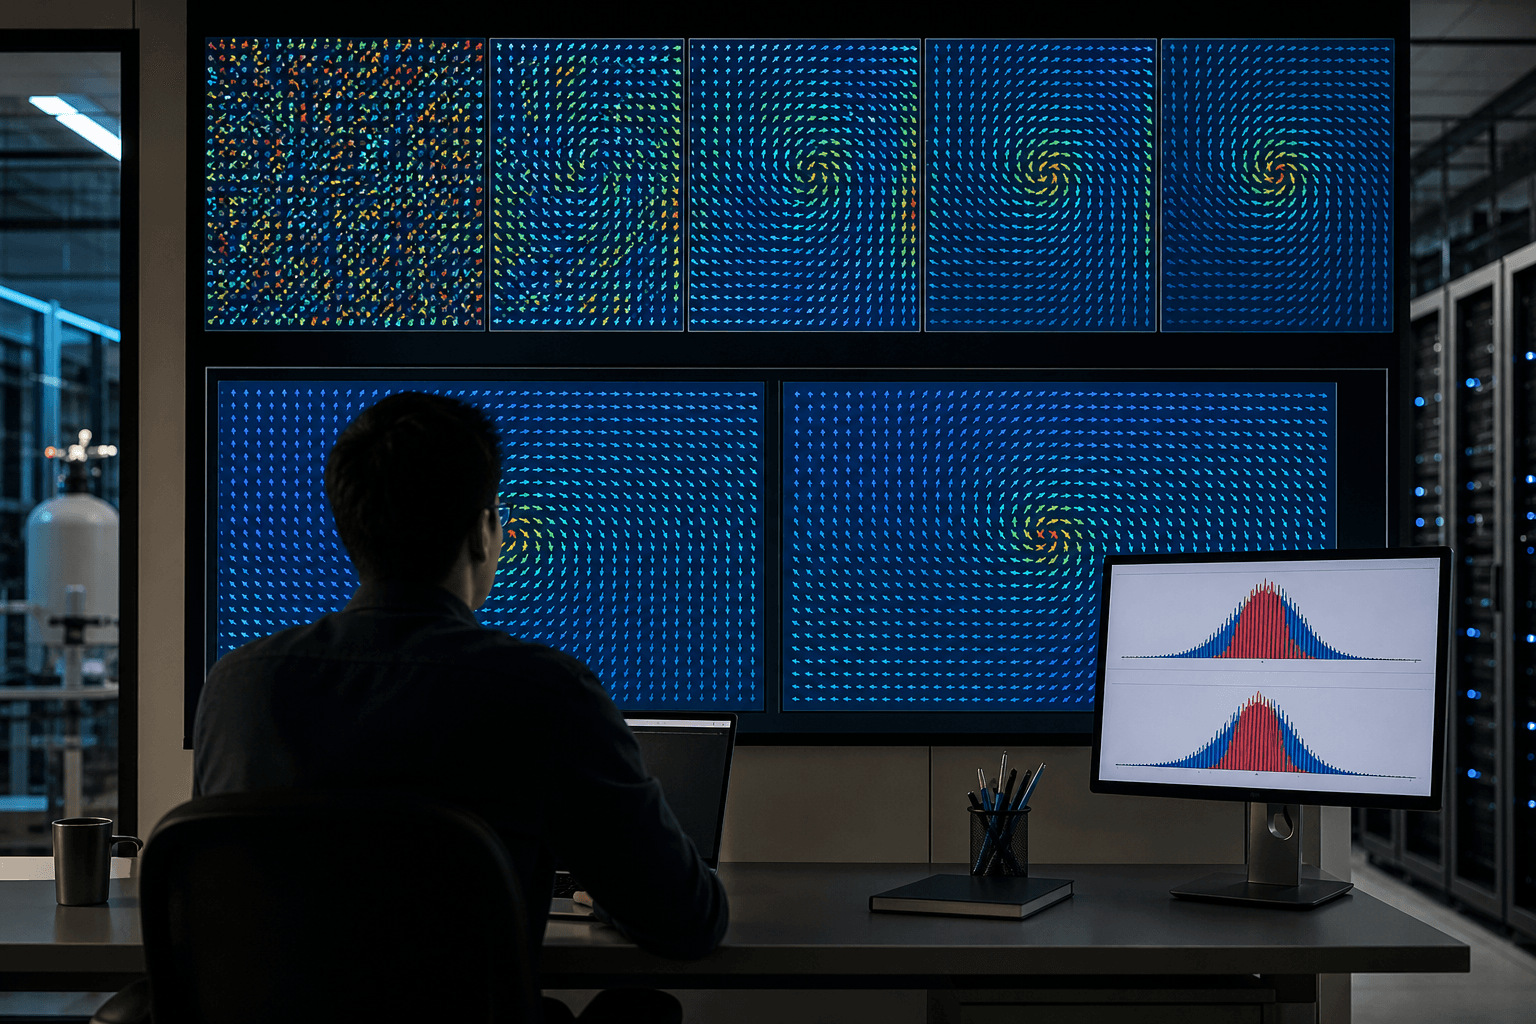
グリンヴァルト氏らの研究チームは、格子場理論における平衡状態の場の configuration、すなわち確率分布に従う物理場のサンプルを、教師データなしで生成する拡散モデルの訓練法を示した。格子場理論は素粒子物理の計算基盤であり、確率分布から独立なサンプルを大量に得ることが最大の計算ボトルネックとなっている。
拡散モデルは有望な生成器であるが、標準的なデノイジング・スコアマッチングは、狙う分布そのものからのサンプルを学習に要する。これでは、サンプルを得るという元の問題を学習の前提に持ち込む循環に陥る。従来は、ハイブリッド・モンテカルロ法(HMC)で生成した参照データに頼っていた。
本研究は、ターゲット・スコア恒等式を用い、モデル自身が生成したサンプルで学習する方式を提案した。必要なのは、正規化されていない確率密度、つまり「各状態のもっともらしさを相対的に計算できる式」のみである。二次元φ4理論で、対称相、臨界点、対称性が破れた相の三つの状況について検証し、HMC参照データでの学習に匹敵する性能を得たと報告している。
しくみをやさしく
拡散モデルは、ノイズを段階的に除去してサンプルを作る生成モデルである。各段階でどちらへ進めばよいかを示す「スコア」、すなわち確率が高くなる方向の勾配を学習する。通常は正解サンプルにノイズを加え、その除去を学ばせるため、正解データが要る。
本研究は、正解データの代わりに、モデル自身が出力したサンプルを使う。ただし、自分の出力で自分を学習させれば、偏りが固定化する恐れがある。そこで、目標の確率密度の値を使って各サンプルに重要度重みを掛け、学習の目標が一貫して本来の分布を指すようにする方式を採った。これは、自己生成した答案を、正しい採点基準で重み付けして採点し直す仕組みに近い。
一方、重みを付けない変種は、モデルの出力と学習目標が一致する点、すなわち自己無撞着な不動点へ収束させる方式と位置づけられている。論文は両系統を比較し、効率的な学習と生成を可能にする設計上の選択肢を特定した。
ビジネスへの示唆
中核となる発想は、「正解データがなくても、評価式さえあれば生成モデルを育てられる」点である。これが当てはまるのは、データは乏しいが、良し悪しを数式で評価できる業務である。
例えば素材・化学メーカーの研究開発部門では、分子や材料の配置について、エネルギー関数で安定度を評価できる場合が多い。実験やシミュレーションで正解データを集めるには時間と費用がかかる。金融機関のリスク管理部門でも、シナリオ生成の確率モデルが数式で与えられながら、十分な標本抽出に計算時間を要する場面がある。
ここで読者に問いたいのは、自部署で、評価の式はあるが、正解データの収集に時間を費やしている業務は何か、そして誰がどれだけ手間をかけているか、という点である。影響を受け得る指標は次のとおりである。
- 研究開発部門:候補探索のサイクル時間、試作・実験回数
- リスク管理部門:シナリオ生成の計算時間、再計算の待ち時間
- 計算基盤部門:計算資源の利用効率
なお本論文が検証したのは二次元の物理モデルにとどまる。産業の実問題への適用可否は、別途の検証を要する点に留意が必要である。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:サンプル生成や探索に時間を費やしている業務を洗い出し、「評価式が書けるか」「正解データがあるか」の二軸で分類する。目指す到達点は、データ不足だが評価式がある業務の候補一覧を、担当者の共通認識として持つことである。
-
差し込み先の設計:新しい基盤を増やさず、既存のシミュレーションや最適化の工程に、生成モデルによる提案を一段加える形を優先する。目指す到達点は、現行の手順を置き換えずに、既存の計算結果と並べて比較できる状態である。
-
小さく試す(PoC):一部署・数週間の範囲で、評価式が明確な小さな問題を選び、従来法の結果と見比べる。目指す到達点は、担当者が「従来法に近い品質のサンプルが得られる」と実感で確かめられることである。
-
運用と横展開:品質の確認基準を文書化し、効果の出た手順を他部署へ広げる。目指す到達点は、評価式の整備からモデルの検証までを、部署が自力で回せる運用である。
全体として目指す状態は、正解データの収集を待たずに、評価式を起点として探索や生成を始められる業務体制である。初期は小さく、安く始められる見込みがある一方、効果は業務ごとに異なる。
今後の展望
本手法は、より高次元の理論や複雑な系へ拡張できるかが焦点となる。格子場理論に限らず、評価式が明示される領域へ展開できれば、データ収集に縛られない生成AI活用の道が開かれる。企業は、自社の評価式をどれだけ整備できているかを、先に点検しておく価値がある。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
小型AIが大型AIの冗長な思考を抑える新手法
推論AIの長い思考を、追加学習なしで約31%短縮しつつ精度を保つ手法「DoubtLess」が登場した。小型モデルが大型モデルの出力を誘導する仕組みで、推論コストの削減に道を開く。
長期作業AI、進捗報酬で訓練し大手に迫る
米大学などの研究チームが、長時間の自律作業をこなすAIエージェントを、手順ごとの進捗を報酬にして訓練する手法を発表した。270億パラメータ級のモデルが一部課題で最先端の商用モデルに並び、業務自動化の裾野を広げる可能性がある。
家庭用GPU4枚で画像生成AIを70分で自作
MiniDogは家庭用GPU4枚で、事前学習55分と微調整15分により画像生成モデルを訓練する枠組みである。独自モデルの内製が大企業以外にも現実的な選択肢となる可能性を示した。