AI偏り診断と抑制法、再学習時の耐性を向上
画像AIが背景など見かけの手がかりに頼る度合いを幾何学的に監視し、抑える手法BiasFlowが登場した。凍結した基盤部分に偏ったデータで新たな出力層を学習させても、最悪グループ精度が40.7%から64.1%に改善した。
研究の概要
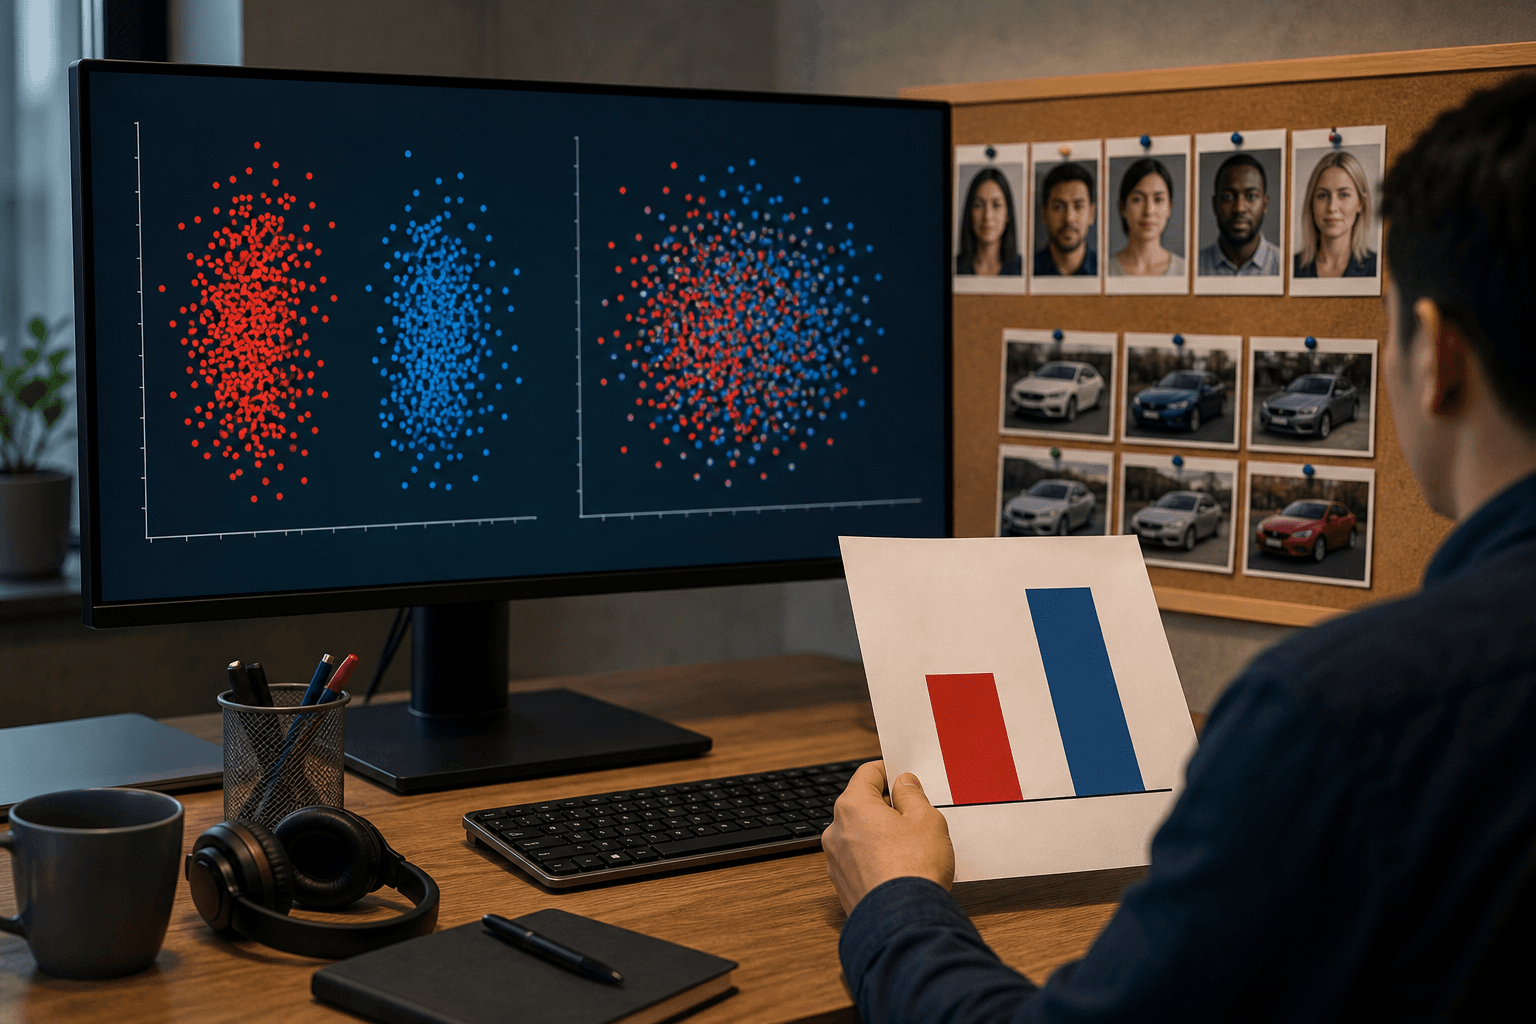
AIが予測に使う手がかりの中には、本来の判断対象と無関係な特徴が混じることがある。例えば、人物の属性を判定する際に背景や性別といった「見かけの相関」に頼る現象である。こうした偏りは平均精度には表れにくく、特定の集団でのみ精度が急落する。そのため、最も成績の悪い集団の精度を示す最悪グループ精度(WGA)が評価指標として使われてきた。
今回の論文は、WGAだけでは不十分だと指摘する。WGAは学習済み予測器の出来を測るが、AIの基盤部分(バックボーン)を固定したまま新しい出力層(ヘッド)を学習し直した場合に、その基盤がどう振る舞うかは捉えられないためである。実務では、基盤モデルを流用して自社データで出力層だけを学習し直す運用が多く、この点は重要である。
研究チームが公開したBiasFlowは、モデル内部にフックを差し込んで特徴量の幾何学的な性質を監視するツールである。測定するのは、クラスと属性の重心の整合度(IBMI)、同一クラス内での属性ごとの重心の分離度(W-IBMI)、特徴射影への感度の三つである。ただしIBMIはクラスと属性の相関に影響を受けるため、因果的な依存度の指標ではないと論文自身が明記している。
併せて提案されたBiasFlow正則化(BFR)は、クラスごとに属性間の重心を近づけるペナルティを損失関数に加える方法である。既存の学習手法に組み合わせられる点が特徴となる。W-IBMIはBFRが最適化する量を確認する指標であり、スケールに依存するため、属性の除去を単独で証明するものではない。
結果として、小規模ベンチマーク全般で平均WGAを改善または維持し、UrbanCarsでは最大26.0ポイントの向上を示した。主要な検証では、CelebA-Std上で学習した基盤を凍結し、偏ったデータで新しいヘッドを学習させた。BFRとGroupDROの併用でWGAは40.7%から64.1%に上昇し、性別(Male)を当てる探索分類器の精度は92.5%から72.2%に低下した。ImageNetに合成透かしを加えた統制実験でも、透かしの変化に対する精度が23.0ポイント改善した。
一方で、属性情報は基盤内になお復元可能であり、タスク間での結果は一様ではない。効果は検証した条件の範囲内にとどまる。
ビジネスへの示唆
注目すべきは、偏りの有無を精度の数字だけでなく、モデル内部の構造から点検できる点である。自社の業務に置き換えると、次のような場面が該当する。
- 製造業の品質管理部門:外観検査AIが、不良品の特徴ではなく撮影ラインや照明の違いを手がかりにしていないか。KPIは誤検知率、見逃し率、再学習の手戻り件数である。
- 人事部門:応募書類のスクリーニングAIが、職務能力ではなく性別や出身校など属性の相関に頼っていないか。KPIは選考の公平性指標と、監査対応にかかる工数である。
- 金融の与信審査部門:審査モデルが、居住地域など属性と相関する変数に依存していないか。KPIは属性別の承認率差と、モデル検証の指摘件数である。
- 医療・ヘルスケア部門:画像診断AIが、病院ごとの撮影機器の癖や院内マーカーを手がかりにしていないか。KPIは施設間での精度のばらつきである。
読者に問いたいのは、自部署でAIや基盤モデルを使っている業務はどれか、そのモデルを誰がどの頻度で再調整しているか、という点である。基盤を流用して出力層だけ学習し直す運用は、データが偏っていると偏りを再び呼び込む恐れがある。論文はこの「再学習への耐性」を評価軸に加えるよう促している。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案することになる。
-
棚卸し:AIを使う業務と、基盤モデルを流用している箇所を一覧にする。あわせて、属性や環境と結果が相関しやすい業務を洗い出す。目指す到達点は、偏りが問題になり得る業務の優先順位が、担当者と管理部門の双方で共有された状態である。
-
差し込み先の設計:新しいツールを増やさず、既存の学習パイプラインや検証手順にBFRとIBMI系の監視を加える形を優先する。BFRは既存手法に組み合わせられる設計であり、この性質が現実的な選択肢となる。目指す到達点は、モデル更新のたびに偏りの診断が自動で出力される状態である。
-
小さく試す(PoC):一つの部署、数週間の範囲で、基盤を固定したまま偏ったデータで出力層を学習し直す試験を行う。WGAに加え、属性の探索分類器の精度を並べて比べ、現場担当者の実感と照合する。目指す到達点は、偏りの出方が現場の感覚と合うかを小さく・安く確かめた状態である。なお、属性情報は完全には消えず、タスクによって結果が異なるため、効果が出ない場合の判断基準もこの段階で決めておく。
-
運用と横展開:合格基準と点検頻度を文書化し、他部署へ展開する。目指す到達点は、精度と並んで偏りへの耐性が、モデルの受け入れ基準として定着した状態である。
全体として目指すのは、AIの精度報告に偏りの診断が標準で添えられ、基盤モデルの流用や再調整が安心して行える運用体制である。
今後の展望
論文が示した効果は、小規模ベンチマークと限定された検証手順の範囲に基づく。大規模な実業務データで同様の傾向が出るかは未検証であり、検証が進むまでは補助的な点検指標として位置づけるのが妥当である。規制対応や説明責任の観点でも、モデルの内部構造から偏りを示せる手段は、監査資料の裏付けとして有力な候補となる。
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ループ型LLM、固定点活用で推論を軽量化
ループ型言語モデルで状態が固定点に近づく性質を利用し、学習・復号・RLを効率化する手法が提案された。KVキャッシュを3分の1にしても精度を保ち、運用コスト低減に道を開く。
拡散モデルの推論、途中から始めて精度向上
拡散モデルによる条件付き生成で、逐次モンテカルロ法を途中時点から開始する手法が提案された。同数の粒子で精度が約2倍に高まり、稀な事象の再現では桁違いの改善も確認された。
動画生成AI、直列と並列の併用でルール違反を抑制
動画生成AIが物理法則や単純な規則を破る問題に対し、高ノイズ段階で順次生成し低ノイズ段階で一括精緻化するS2PDが提案された。生成映像の信頼性向上に道を開く手法である。