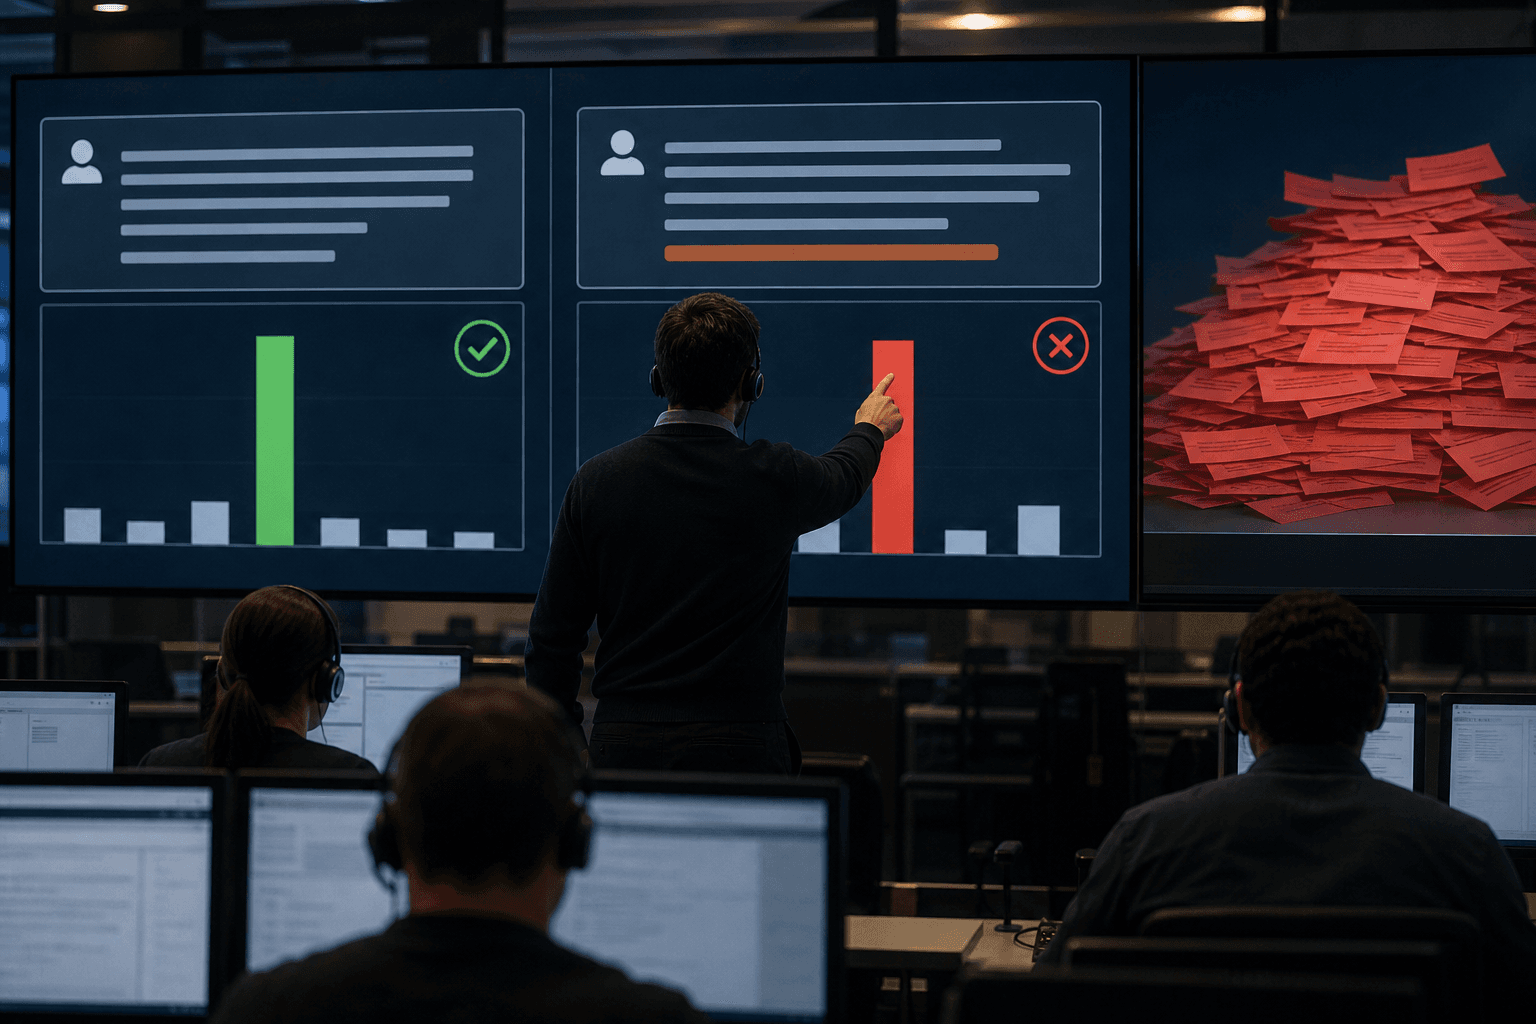
AIがデータ科学者に、合成データ自動生成
MetaのAI研究チームが、AIエージェント自身が高品質な学習データを自律的に生成・改善する手法「Autodata」を発表した。データ整備コストの削減と専門AIモデルの開発加速が企業の競争力に直結する可能性がある。

研究の概要
Meta AIの研究チームは、AIエージェントが「データ科学者」として機能し、高品質な学習・評価用データを自律的に構築する汎用手法「Autodata」を発表した。同手法の核心は、データ生成エージェント自体をメタ最適化する仕組みにある。エージェントはデータを生成するだけでなく、その生成プロセスを繰り返し改善することで、より質の高いデータを継続的に産出できる。
具体的な実装として「Agentic Self-Instruct」が提案され、コンピュータサイエンス研究タスク、法的推論タスク、数学的対象を用いた推論タスクの3領域で検証が行われた。いずれも従来の合成データセット生成手法を上回る結果が得られており、エージェントのメタ最適化を加えることでさらに大幅な性能向上が確認されている。論文は「推論時の計算資源の増大を、モデル学習品質の向上に転換する手段」と位置づけており、AIデータ構築の在り方そのものを変革する可能性を示唆している。
ビジネスへの示唆
Autodataが企業にもたらす最大の変化は、高品質な学習データの調達・整備にかかるコストと時間の大幅な圧縮である。現状、業界特化型AIモデルの開発における最大のボトルネックは、専門知識を持つアノテーターの確保とデータラベリングの工数にある。
影響を受ける主な業種・部門とKPIは以下の通りである。
- 法務部門・リーガルテック企業: 契約審査や判例分析AIの学習データ生成を自動化することで、モデル開発期間を短縮。契約審査の自動化率や法的リスク検出精度が主要KPIとなる。
- 金融機関のリスク管理部門: 規制対応や不正検知モデル向けに希少事例データを合成生成し、検知精度(適合率・再現率)の向上につなげられる。
- 製造業のR&D・品質管理部門: 設計不良や異常検知モデルの学習データ不足を合成データで補完し、不良品流出率の低減が期待できる。
- 医療・製薬企業のデータサイエンス部門: 個人情報保護規制下で実データの利用が制限される場面において、合成データによる臨床推論モデルの訓練が可能となる。
また、AIシステム開発を内製化している大手テクノロジー企業やコンサルティングファームにとっては、専門AIモデルの開発コスト削減と市場投入速度(タイム・トゥ・マーケット)の改善が直接的な競争優位につながる。データ整備に充てていた人員をモデル評価・改善に再配置できる点も、組織効率化の観点から注目される。
今後の展望
Autodata が示す方向性は、AIモデルの性能向上を「データの量と質」から「エージェントによる自律的なデータ改善サイクル」へと転換するものである。この枠組みが成熟すれば、各企業が自社業務ドメインに特化したデータ生成エージェントを保有し、継続的にモデルを自己改善させるという開発体制が現実的な選択肢となる。
一方で、合成データの品質保証や偏り(バイアス)の検証、生成データに起因するモデルの崩壊リスクといった技術的課題は残存する。特に医療・法務・金融といった高リスク領域での実用化に際しては、生成データの妥当性を担保するガバナンス体制の整備が不可欠である。データ倫理・AI規制の動向と合わせて継続的な注視が求められる。
関連トピック
同セクションの記事
微小介入でAI応答を制御、品質劣化防ぐ新手法
米ジョンズ・ホプキンス大学などの研究チームが、大規模言語モデルを再学習せずに出力傾向を調整する手法「MISVO」を発表した。低コストで応答品質を維持したまま報酬を最適化でき、企業のAI運用コスト削減につながる可能性がある。
PoEM、AI再学習なしで挙動予測
MITなどの研究チームが、既存の強化学習済みモデル群から新たな報酬関数向けの学習結果を追加学習なしに予測する手法「PoEM」を提案した。生成AI開発における再学習コストの圧縮と迅速な報酬設計の検証を可能にする。
自然な文脈で意思決定AIの判断が反転する
短く自然な文脈を付け足すだけで、正解していた意思決定AIの判断を高確信度の誤答へ誘導できるとの研究結果が公表された。AIの確率出力を業務判断の根拠とする企業に、運用の再考を促す内容である。