非同期パイプライン並列学習、大規模LLM開発を加速
米欧の研究チームが、大規模言語モデルの事前学習における非同期パイプライン並列処理の性能劣化問題を解決する手法を発表した。GPU稼働率の抜本的改善により、AI開発コストの大幅削減が見込まれる。
研究の概要
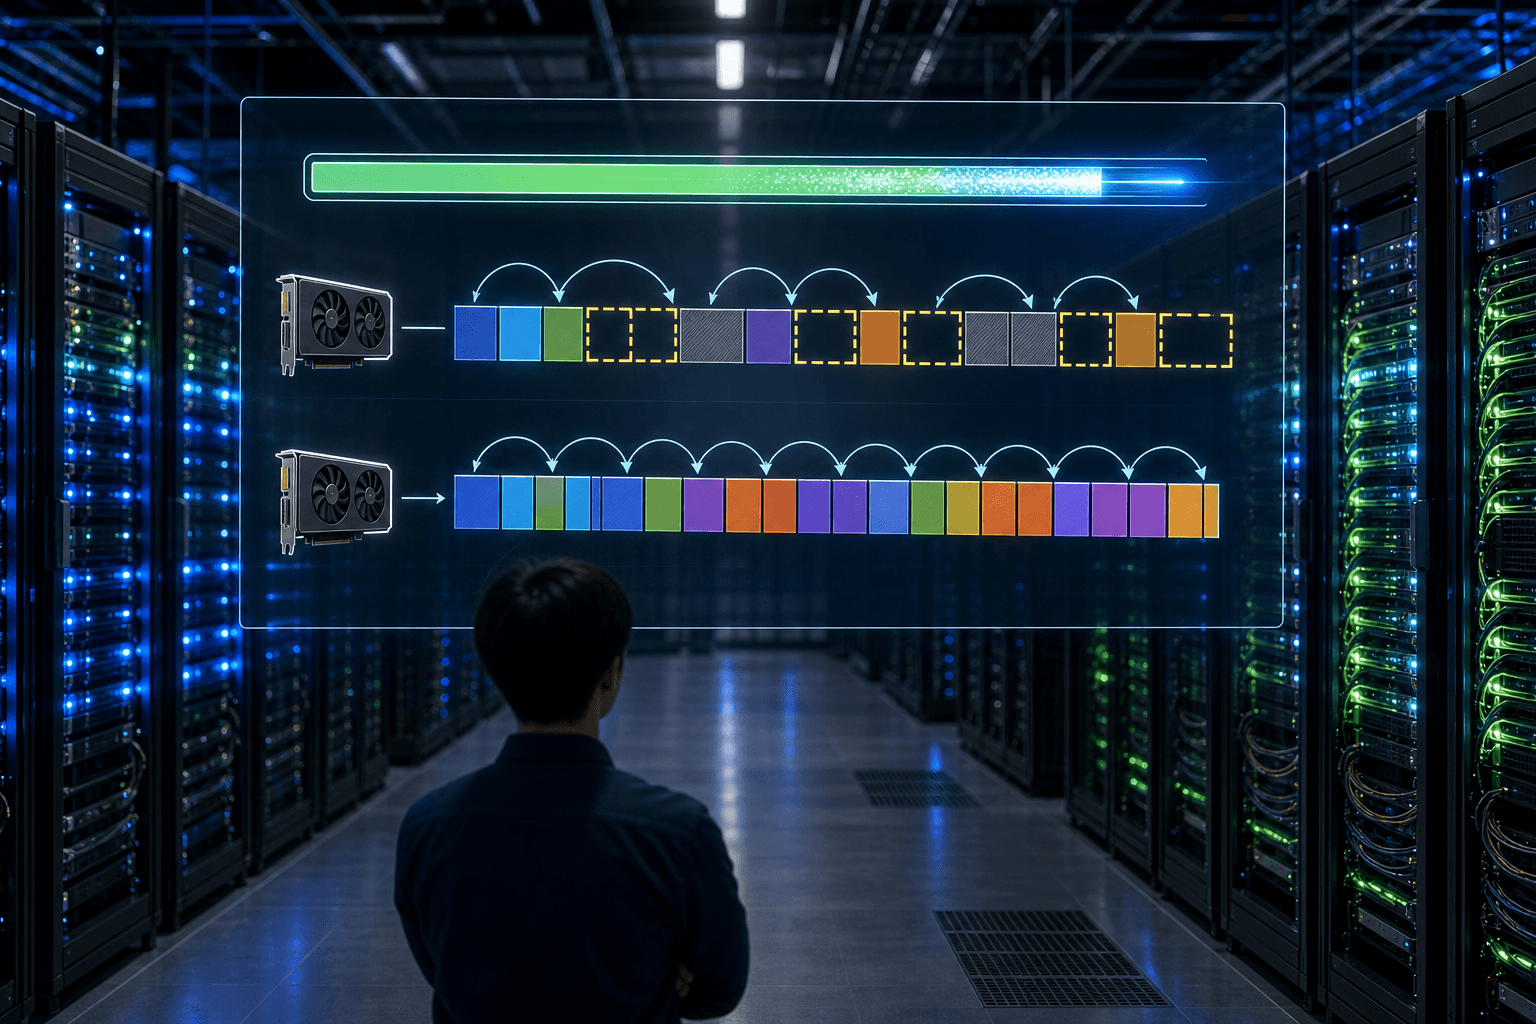
大規模言語モデル(LLM)の事前学習において、複数のGPUを効率的に活用するための技術として「パイプライン並列処理」が広く採用されている。しかし従来の同期型実装では、GPUが処理待ちとなる「パイプラインバブル」と呼ばれる空き時間が不可避的に発生し、計算資源が無駄になるという課題があった。
Philip Zmushkoらの研究チームは、この問題を解消する非同期型スケジュール「PipeDream-2BW」に着目した。同手法はパイプラインの深さによらず勾配の遅延を常に1ステップに抑えられる優れた特性を持つが、「遅延下での学習は根本的に不安定」という通念から実用化が進んでいなかった。
研究チームはこの通念に正面から異議を唱え、性能劣化がオプティマイザの選択に強く依存することを実証した。現在主流のオプティマイザ「AdamW」は1ステップの勾配遅延のもとで深刻な精度低下を示す一方、近年注目される「Muon」と呼ばれるオプティマイザは強い堅牢性を発揮することを確認した。さらに「誤差フィードバック」に着想を得た補正手法を組み合わせることで、遅延の影響をさらに低減できるという。100億パラメータ規模のモデルでの検証でも、同期型学習との性能差をほぼ解消できることが示された。
ビジネスへの示唆
この研究が持つ産業界への影響は広範にわたる。LLMの開発・運用に多大な投資を行う企業にとって、GPU稼働率の向上は直接的なコスト削減につながるからだ。
パイプラインバブルによるGPU空き時間はクラスタ規模が大きくなるほど深刻化する。非同期処理によってこれを排除できれば、同じ計算予算でより大規模なモデルを学習させることが可能となり、学習コストあたりのモデル性能というKPIを大きく改善できる。
影響が特に大きい領域は以下のとおりである。
- クラウド・インフラ事業者: データセンターのGPU稼働率(利用率)向上により、同一設備でのサービス提供能力が拡大する
- 金融・保険業のAI部門: 独自LLM開発における計算費用を圧縮し、モデル更新サイクルの短縮が見込める
- 製薬・創薬研究部門: 大規模な分子設計モデルや臨床文書解析モデルの学習期間短縮につながる
- 通信・メディア企業のMLOpsチーム: GPU予算の最適化指標(コストパーFLOP)改善に直結する
また、自社データセンターを持たず外部クラウドを利用する企業にとっても、学習時間の短縮は従量課金コストの削減を意味する。研究成果はオープンな形で発表されており、主要なディープラーニングフレームワークへの実装が進めば、特定ベンダーに依存せず広く活用できる可能性がある。
今後の展望
本研究の成果がフレームワークに統合されれば、数百億から数千億パラメータ規模のモデル開発における標準的な学習手法が塗り替えられる可能性がある。オプティマイザ選択という実装上の判断が、インフラ投資の効率を左右するという知見は、AI開発戦略の立案においても重要な示唆を与える。
一方で、Muonオプティマイザ自体がまだ普及途上にあり、既存の学習パイプラインへの移行にはエンジニアリングコストが伴う点も考慮が必要だ。今後は実装の簡便化と、より多様なモデルアーキテクチャへの適用検証が課題となろう。AI開発コストの削減競争が激化する中、非同期並列学習の実用化は業界全体の開発速度を底上げする可能性を秘めている。
同セクションの記事
LoRA合成の干渉を新手法READが解消
複数のLoRAアダプタを推論コストなしで一つのモデルに統合する新手法READが提案された。新技能は旧技能を読むが書き換えない設計で、SuperGLUEで20点超の改善を示した。
LLM内部の利用者像を可視化し書換え
AIが対話相手について抱く暗黙の想定を読み出し、書き換える手法BSDが提案された。拒否判断が利用者像に左右されると示され、AI安全性の管理に影響する。
生成AIの出力属性を後処理で目標分布に整合
米研究チームは、内部に触れられない生成AIの出力を、繰り返し問い合わせと選別で属性分布を目標に近づける手法を提案した。クエリ数最小化と漸近最適性も示し、公平性対応やデータ生成の実務に影響する。